
티스토리 뷰
[AV-TSE]EvoTSE: Evolving Enrollment for Target Speaker Extraction (arXiv:2604.06810v2)
Vagabund.Gni 2026. 9. 4. 07:55목차
TL;DR
앞 편이 설계한 어댑터는 동결한 백본에 뱅크를 끼우는 자리였고, 그 뱅크에 무엇을 넣을지는 열려 있었다.
EvoTSE는 등록 음성을 녹음해 둔 한 토막으로 고정하지 않는다.
한 세션을 이어지는 과정으로 보고 지금까지 뽑아낸 결과 가운데 믿을 만한 것을 골라 등록 음성을 매 걸음 다시 만든다.
그렇게 하면 뱅크가 스스로 오염될 수 있다. 잘못 뽑은 세그먼트가 다음 걸음의 기준이 되고 오류가 쌓이기 때문이다.
이 논문이 그 자리에 넣은 것이 신뢰도 임계값 τ 하나다.
논문이 WSJ으로 학습한 모델에서 그 값을 0.0으로 두면 SI-SDRi가 1.03 dB,
0.5로 두면 10.73 dB라 적는데 그 두 값의 차가 9.70 dB이고 걸러내지 않은 1.03은 등록 음성을 고정한 기준선 2.09보다도 낮다.
저자 공개 구현을 열어 다시 세니 논문이 적은 규격은 여섯 값 가운데 다섯이 설정 파일과 맞았고 백본은 15,641,885개였다.
그런데 논문이 뱅크 슬롯을 예순넷이라 적는데 배포된 설정은 열여섯이고,
뱅크가 꽉 찼을 때 무엇을 뺄지 정하는 축출에는 논문에 없는 폐기 분기가 있다.
그리고 임계값을 바꾸는 명령줄 인자는 읽는 곳이 없어 임계값을 바꿔 가며 잰 그 곡선을 배포된 코드로는 다시 그릴 수 없다.
다음 편은 ISAM이다.
그 논문은 화면에 함께 있는 다른 얼굴을 단서로 쓰되 그 얼굴이 없을 때 성능을 잃지 않는 훈련법을 다룬다.
이 편이 뱅크에 무엇을 넣을지를 정했다면 그 편은 그 단서가 없을 때 무엇을 할지를 정한다.
들어가며
앞 편은 동결한 백본에 어댑터를 끼우는 설계를 읽었다.
Flamingo가 동결한 언어모델 사이에 교차 어텐션 층을 넣고 tanh 게이트를 0에서 시작시켜 처음에는 항등이 되게 만든 그 구조다.
어댑터를 어겼을 때 얼마를 잃는지는 그 편이 값으로 냈고,
몇 층에 끼울지와 그 어댑터가 들고 있을 것이 무엇인지는 열어 두었다.
이번 편이 받는 것은 뒤엣것이다. 기억 뱅크에 무엇을 넣고 무엇을 버릴지를 정하는 규칙이 없으면 어댑터는 쓰레기를 읽는다.
논문은 본문 여덟 쪽에 번호 붙은 수식이 열하나, 표가 넷, 그림이 다섯이고 부록은 없다.
Interspeech 2026에 낸 투고본이라 아직 채택되지 않았고, 저자 저장소가 심사본을 함께 냈다.
이 글은 논문의 논증을 순서대로 따라가고 7번 섹션에서 저자 공개 구현으로 다시 센다.
배포 체크포인트도 학습 로그도 없어 층을 옮겨 세어 총계와 맞추는 방식은 못 쓰고, 설정 파일과 소스를 읽어 식을 세운다.
판본이 셋이다. arXiv v1과 v2, 그리고 저자 저장소의 Interspeech 심사본이다. 기준은 v2이고 그 이유는 1.2가 든다.
1. 고정된 등록 음성 하나로는 긴 대화를 못 따라간다
1.1 앞 편이 남긴 자리
Flamingo 편은 어댑터가 처음에 무엇을 하는지와 그것을 어겼을 때 얼마를 잃는지를 값으로 냈다.
게이트를 0으로 초기화하면 붙인 직후의 모델이 원래 모델과 똑같이 동작하고, 학습이 진행되면서 그 값이 열린다.
그 편에서 우리가 센 것은 삽입 간격에 따른 파라미터 증가분이었고,
몇 층에 끼울지도 어댑터가 무엇을 참조하는지도 그 편은 정하지 않았다.
참조 대상이 정해지지 않으면 어댑터는 설계가 끝난 것이 아니다.
MeMo 편에서 본 memory bank는 추출 결과를 슬롯에 담아 두고 다음 걸음에서 다시 쓰는 장치인데,
무엇을 담을지에 대한 판정이 없었다.
그 편의 'membank.add()'는 들어온 것을 무조건 뒤에 붙인다.
그러면 한 번 잘못 뽑은 세그먼트가 밀려날 때까지 참조로 쓰인다.
방해 화자의 목소리가 슬롯에 들어가면 그다음 걸음이 그것을 기준으로 삼고, 그 결과가 또 슬롯에 들어간다.
오류가 스스로를 강화하는 고리가 만들어지는 것이다.
이 논문은 정확히 그 자리에 판정을 하나 넣는다.
새 추정치를 뱅크에 넣기 전에 화자 임베딩으로 신원을 확인하고, 임계값을 못 넘으면 버린다.
그리고 뱅크가 꽉 찼을 때 무엇을 뺄지도 함께 정한다.
읽는 이유는 그 두 규칙이다. 성능표가 아니라 쓰기 게이트와 축출 규칙을 보려고 이 논문을 연다.
1.2 아직 채택되지 않은 투고본이다
arXiv 초록 페이지에 학회 DOI도 저널 참조도 없고,
저자 저장소가 함께 낸 PDF의 메타데이터 제목이 'Under review'이고
본문 둘째 줄이 'Anonymous submission to Interspeech 2026'이다.
그래서 이 글은 게재본 DOI를 쓰지 않고 arXiv ID를 식별자로 쓴다.
유일하게 존재하는 DOI는 arXiv가 자기 항목에 붙인 '10.48550/arXiv.2604.06810'이다.
판본이 셋인데 갈리는 자리가 거의 없다. arXiv v1과 v2는 두 줄만 다르다.
익명 저장소 주소가 'github.com/IiuZiKai/Evo_TSE'로 바뀐 것과 arXiv 스탬프뿐이고, 표 값은 한 자리도 갈리지 않는다.
심사본과 arXiv v2도 본문이 같다.
공백을 전부 걷어내고 문자 단위로 견주면 유사도가 0.9940이고
3자 이상 차이 나는 블록 열넷이 전부 저자 익명화와 저장소 주소와 arXiv 스탬프와 그림 눈금 추출 차이다.
값이 갈린 자리는 없다.
이것은 앞 편들과 다른 상황이다. SepReformer 편은 판본마다 표 값이 갈렸고 MeMo 편은 PDF와 HTML이 갈렸다.
이 편에는 그 축이 없으므로 판본 때문에 수치를 의심할 필요가 없다.
다만 인용문은 심사본 추출에서 뽑는다. arXiv v2는 GenPDF 재생성본이라 텍스트 층에서 단어 안에 공백이 박힌다.
값 대조는 v2로 하고 문장은 심사본에서 가져오는 것이 안전하다.
1.3 화자를 잘못 잡는 실패는 따로 센다
목표 화자 추출이 음성 분리와 다른 점은 누구를 뽑을지가 입력으로 주어진다는 것이다.
분리는 섞인 목소리를 전부 갈라 놓고 어느 것이 누구인지는 나중에 정한다. 추출은 등록 음성이 가리키는 한 사람만 낸다.
그래서 분리가 겪는 전역 순열 모호성이 추출에는 없다.
대신 다른 실패가 생긴다.
등록 음성이 가리키는 사람과 방해 화자가 음향적으로 비슷하면 모델이 방해 화자를 뽑아 놓고 성공했다고 믿는다.
논문은 이것을 화자 혼동이라 부르고 초록의 첫 문제로 든다.
이 실패는 dB 평균에 잘 안 보인다.
삼천 개 세그먼트 가운데 백 개에서 엉뚱한 사람을 뽑아도, 나머지 이천구백 개가 잘 나오면 평균은 여전히 높다.
평균이 감추는 것이 이 실패의 성질이다.
그래서 논문은 지표를 하나 더 쓴다. 개선치가 음수인 세그먼트의 비율을 세는 NSR이다.
목표 화자 대신 방해 화자를 뽑으면 개선치가 음수로 떨어지므로, 그 비율이 곧 화자를 잘못 잡은 비율의 근사가 된다.
지표를 둘로 갈라 놓고 보면 이 논문이 무엇을 고쳤는지가 훨씬 또렷해진다.
6번 섹션에서 다시 보겠지만 이 논문은 분리 능력을 올린 것이 아니라 누구를 분리할지를 덜 틀리게 만든 것이다.
1.4 목소리는 한 세션 안에서도 달라진다
등록 음성은 미리 녹음해 둔 것이고 보통 몇 초짜리 한 토막이다.
그 한 토막이 그 사람의 목소리를 대표한다고 보는 것이 정적 파이프라인의 전제다.
짧은 발화를 하나씩 처리하는 동안에는 그 전제가 대체로 성립한다.
문제는 세션이 길어질 때다. 사람은 한 대화 안에서도 감정이 바뀌고 발성 노력이 달라진다.
화가 났을 때와 차분할 때의 음향 특징은 같은 사람이라도 꽤 멀어진다.
논문은 이것을 정적-동적 불일치라 부른다. 기준은 고정돼 있는데 대상은 움직이는 상황이다.
그 간격이 벌어지면 등록 음성이 지금의 목표 화자보다 방해 화자에 더 가까워지는 순간이 생긴다.
그 순간이 바로 화자 혼동이 일어나는 자리다.
모델은 등록 음성과 닮은 쪽을 뽑도록 학습됐으므로, 기준이 어긋난 상태에서는 성실하게 틀린 답을 낸다.
논문의 실험이 이 지점을 정면으로 겨냥한다.
5번 섹션에서 보겠지만 감정 음성 데이터셋을 들여오는 이유가 이것이고,
시작 등록 음성의 감정을 바꿔 가며 재는 표 2가 그 간격의 크기를 보여 준다.
1.5 앞선 대응은 등록을 고르는 쪽이 아니었다
이 문제에 대한 기존 연구는 크게 두 갈래였다. 하나는 구조를 다듬는 쪽이다.
논문은 초기 얼개들부터 USEF-TSE와 X-TF-GridNet 같은 최근 모델까지를 그 갈래로 묶고,
같은 성별 혼합처럼 어려운 조건에서 신원 구별력을 올린 진전이 있었다고 적는다.
다른 하나는 등록 음성 자체를 다듬는 쪽이다. 여기도 둘로 갈린다.
잡음이나 겹침이 섞인 등록 음성에 대해 화자 인코더를 강건하게 만드는 연구가 하나이고,
추론하는 그 세션에서 등록 음성을 직접 뽑아내는 연구가 다른 하나다.
뒤쪽은 다시 갈린다.
혼합 신호에서 겹치지 않는 구간을 찾아 참조로 쓰는 방식이 있고, 여러 단계에 걸쳐 화자 표현을 반복해 다듬는 방식이 있다.
논문이 이 갈래들에 대해 하는 지적은 하나다.
그 방법들이 등록 음성의 잡음이나 부족에 대한 내성은 올렸지만,
문맥에 맞는 등록 음성을 고르는 문제는 거의 건드리지 않았다는 것이다.
대부분은 그 사람의 평균적인 신원 표현을 안정적으로 얻는 쪽을 목표로 삼는다.
평균은 움직이는 대상을 따라가지 못한다.
감정이 바뀌어 목소리가 옮겨 갔을 때 필요한 것은 더 안정된 평균이 아니라 지금 상태에 가까운 참조다.
이 논문이 뒤집는 지점이 그것이다.
1.6 이 논문이 뒤집은 것
정적 파이프라인은 각 세그먼트를 서로 무관한 독립 사건으로 다룬다.
앞에서 무엇을 뽑았든 다음 세그먼트는 처음부터 다시 시작하고,
세션이 아무리 길어도 모델은 그 사람에 대해 아무것도 축적하지 않는다.
이 논문은 그 처리를 관계적 추론으로 바꾼다.
긴 혼합 신호를 세그먼트의 열로 보고, n번째를 처리할 때 앞선 n−1개에서 뽑아낸 화자 단서를 함께 넣는다.
발상의 출처는 RAG다.
언어모델이 답을 만들기 전에 외부 문서를 조회해 근거를 붙이듯,
이 논문은 추출하기 전에 지나온 결과를 조회해 등록 음성을 붙인다.
다른 점은 생성이 아니라 추출이고 조회 대상이 문서가 아니라 자기가 만든 파형이라는 것이다.
자기가 만든 것을 다시 쓴다는 점이 이 얼개의 힘이자 위험이다.
세션이 길수록 참조가 풍부해지지만 한 번 틀리면 그 틀린 것이 다음 걸음의 근거가 된다.
그래서 이 논문이 실제로 다루는 것은 조회가 아니라 무엇을 뱅크에 넣을지 정하는 판정이다.
3번 섹션이 그 자리이고 이 글이 이 논문을 읽는 이유도 거기에 있다.
2. 조회가 등록 음성을 매 걸음 갈아 끼운다
2.1 정적 매핑과 이어지는 추론
논문 3.1절은 정적 설정을 먼저 적는다.
혼합 신호 x에서 목표 신호 s를 뽑아내는데 참조로 등록 음성 r이 주어지고, 처리는 's = Model(x, r)'라는 한 줄로 끝난다.
잔향과 소음까지 넣은 일반형이 식 (1)이고, 이 논문은 무향에 소음이 없고 방해 화자가 하나인 설정으로 좁혀 식 (2)를 쓴다.
논문 3.2절이 그 한 줄을 바꾼다.
긴 혼합 신호를 세그먼트의 열로 놓고, n번째 출력을 's_n = Model(x_n, r, M_{n-1})'로 적는다.
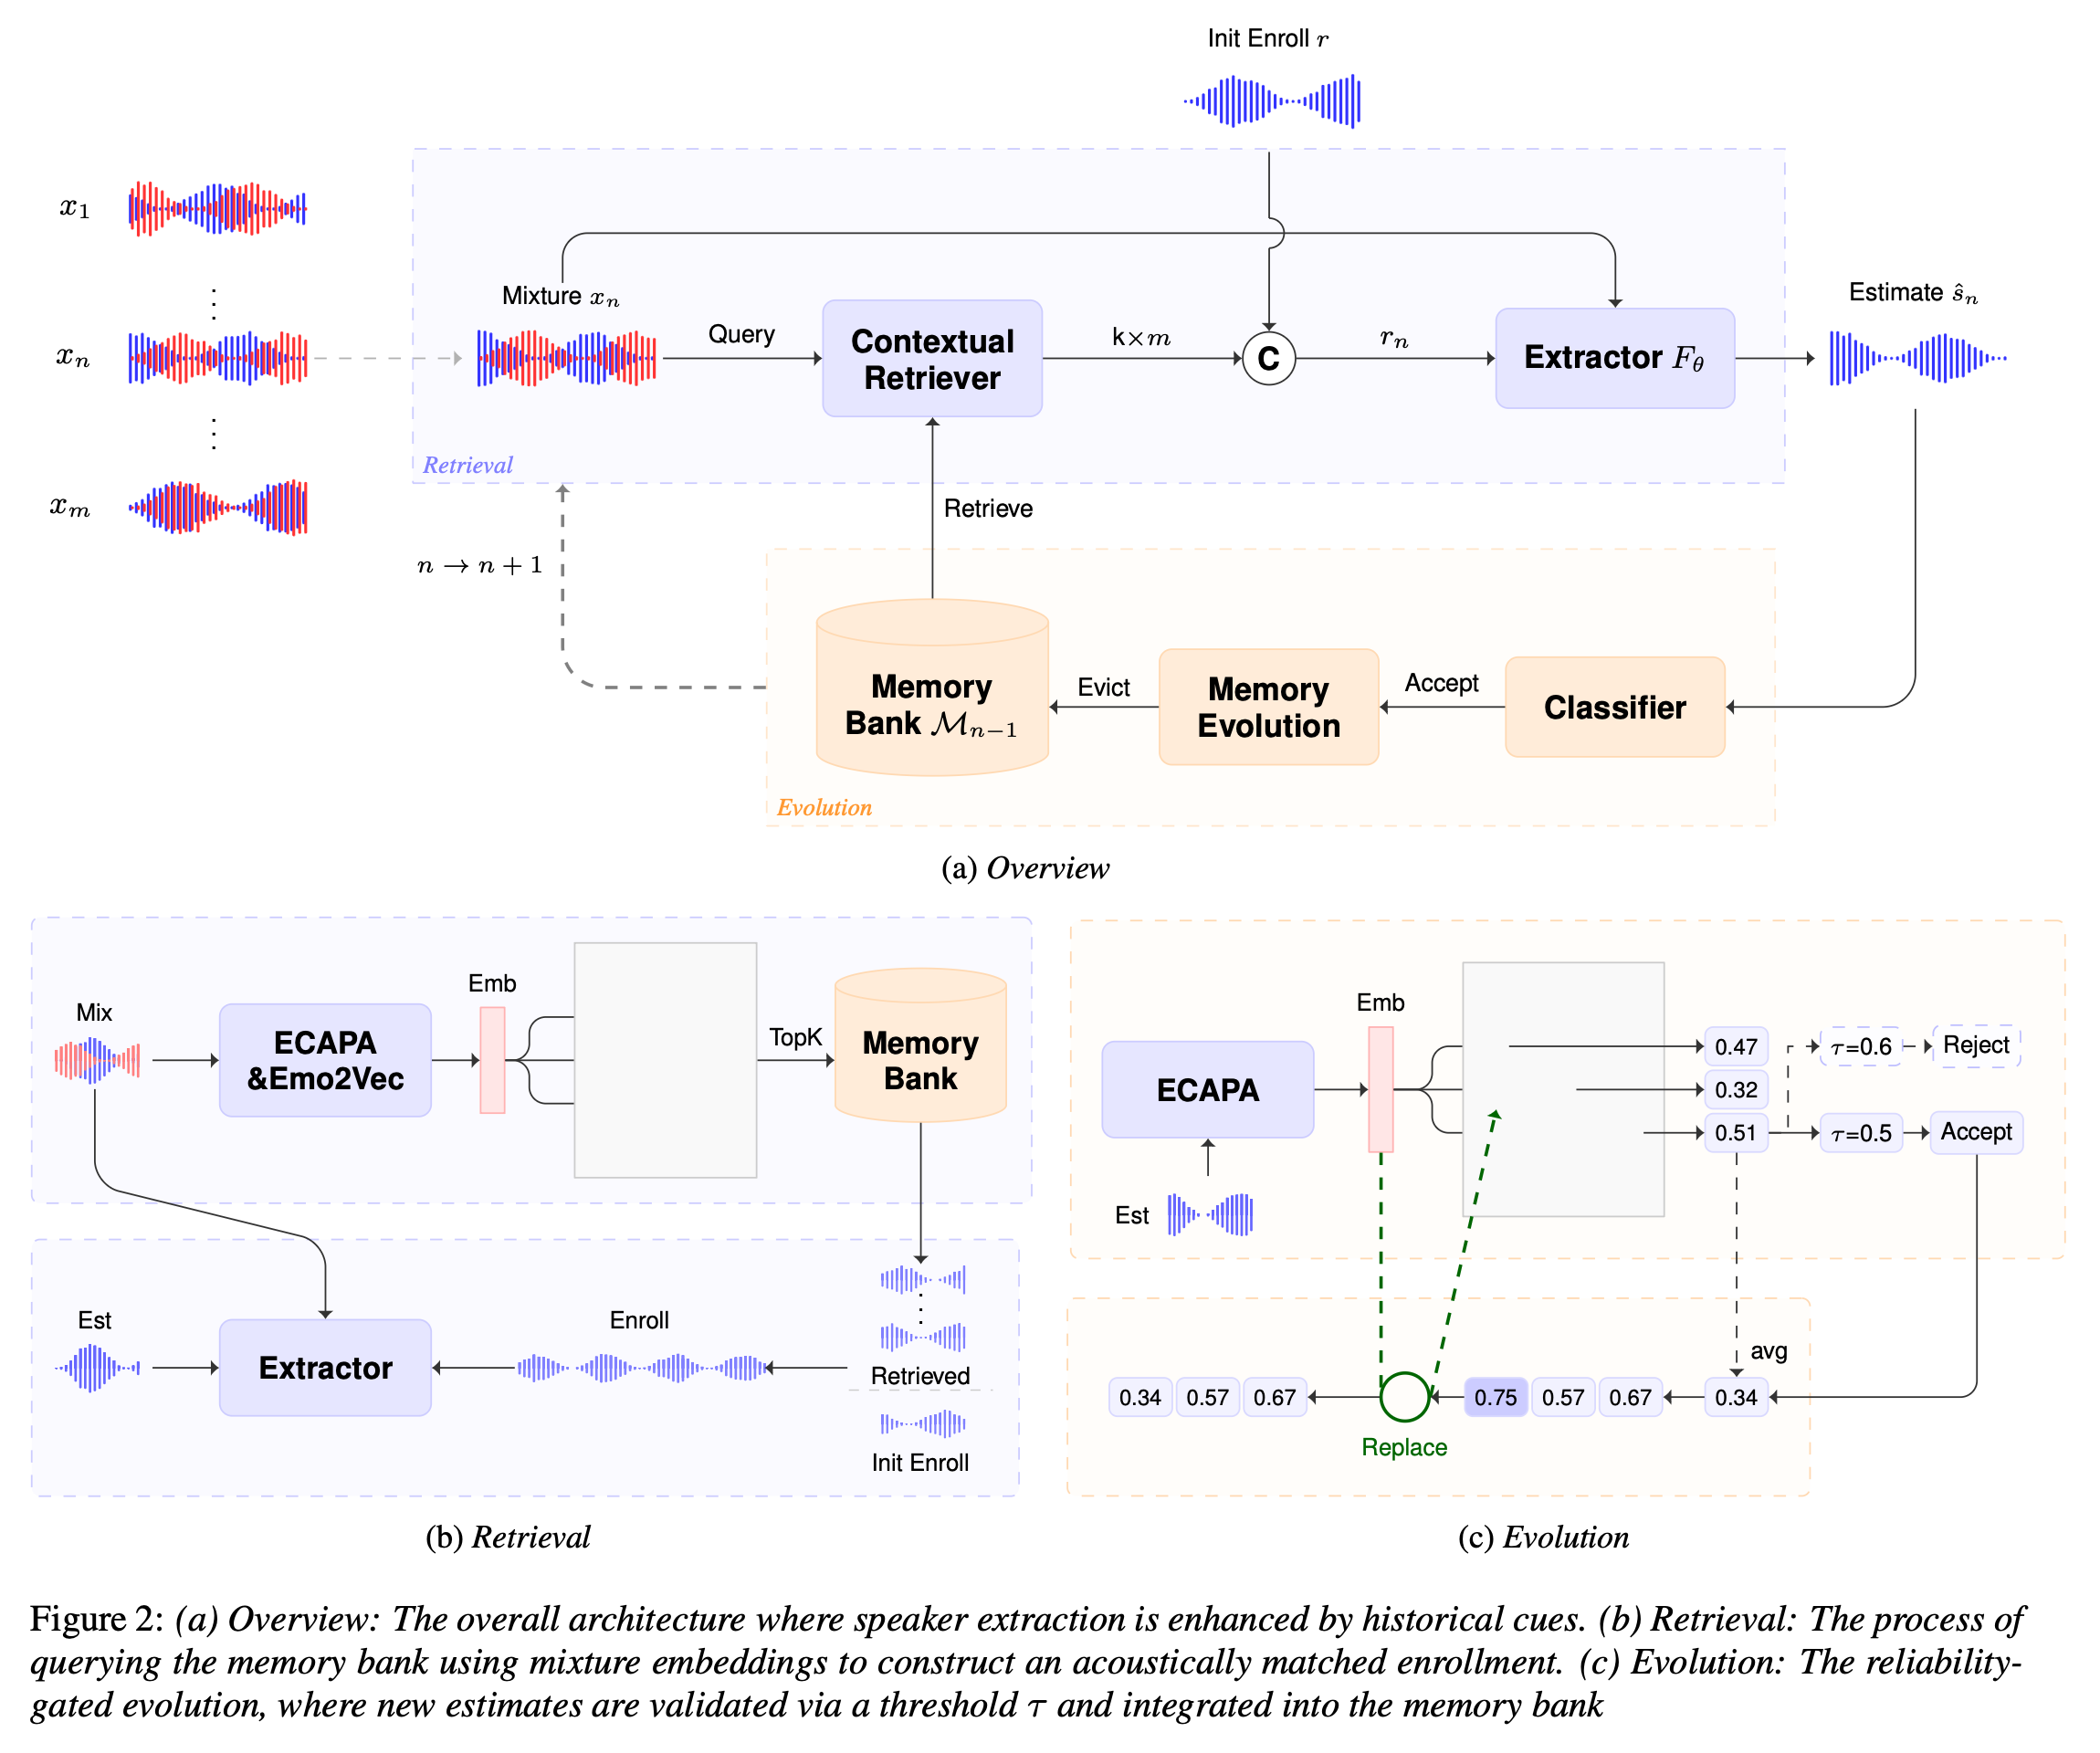
인자가 하나 늘었고 그것이 상태 변수이며, 그 얼개 전체가 그림 1의 (a)다.
M은 지나온 n−1개의 추정치에서 뽑아낸 화자 단서를 담는다.
이 논문은 그것을 memory bank라 부르고, 슬롯에 파형과 임베딩을 함께 담아 둔다.
식이 한 인자 늘어난 것뿐이지만 성질이 완전히 달라진다.
정적 설정에서는 세그먼트의 순서를 뒤섞어도 결과가 같지만, 이 설정에서는 순서가 결과를 바꾼다.
앞에서 무엇을 뽑았느냐가 뒤의 참조를 정하기 때문이다.
논문은 이 처리가 CSS와 비슷하다고 적으면서도 차이를 분명히 한다.
CSS는 모든 음원을 갈라내지만 이쪽은 등록 음성이 가리키는 한 사람만 뽑는다.
2.1.1 memory bank와 슬롯
앞 편들에서 memory bank를 이미 봤지만 담기는 것이 다르다.
MeMo 편은 뱅크를 둘 두어 각각 화자 임베딩과 음성 임베딩을 담았다.
그 편의 speaker bank는 추출 결과에서 화자 벡터를 뽑아 슬롯에 넣은 뒤 그 벡터들을 섞어 참조 벡터를 만들었다.
이 논문의 뱅크는 파형을 담는다. 슬롯 하나에 추출된 음성 토막과 그 화자 임베딩과 감정 임베딩이 함께 들어간다.
조회할 때 쓰는 것은 임베딩이지만 백본에 넘기는 것은 파형이다.
이 차이가 나중에 크게 작용한다.
임베딩을 담으면 여러 개를 평균해 벡터 하나로 만들 수 있지만, 파형을 담으면 시간축으로 이어 붙이는 수밖에 없다.
2.6과 2.8이 그 자리다.
슬롯 개수는 유한하다. 논문은 용량을 '|M|max'로 두고 꽉 차면 하나를 빼는 규칙을 논문 4.5절에 적는다.
그 값이 얼마인지는 3.6에서 다시 본다.
2.2 RAG를 음성 추출로 옮긴 것이다
RAG는 언어모델이 답을 만들기 전에 외부 지식에서 관련 문서를 조회해 함께 넣는 얼개다.
모델 안에 없는 사실을 밖에서 가져오고, 무엇을 가져올지는 지금 들어온 질문이 정한다.
이 논문은 그 세 동작을 그대로 옮긴다.
질의가 있고 조회가 있고 조회한 것을 원래 입력에 붙이는 증강이 있으며, 그 세 동작이 그림 1의 (b)다.
다른 것은 마지막 단계다. 언어모델은 붙인 문서를 근거로 문장을 생성하지만 이 모델은 붙인 파형을 참조로 음성을 추출한다.
지식의 출처도 다르다.
RAG의 문서는 밖에서 온 것이고 모델이 만든 것이 아니지만, 이 논문이 조회하는 것은 자기가 방금 뽑아낸 결과다.
외부 지식이 아니라 자기 이력이다.
그래서 RAG에는 없는 위험이 하나 생긴다. 문서 데이터베이스는 모델이 틀린다고 오염되지 않지만 이 뱅크는 오염된다.
논문이 4.4절에 게이트를 넣는 이유가 그것이다.
이름을 빌려 온 만큼 얼개의 모양은 잘 대응한다.
논문 4.1절이 부품 넷을 나열하는데 문맥 조회기와 백본 추출기와 신뢰도 분류기와 memory curator이고,
앞의 둘이 RAG의 조회와 생성에, 뒤의 둘이 이 논문이 새로 붙인 안전장치에 해당한다.
2.2.1 RAG와 검색 증강 생성
RAG는 retrieval-augmented generation의 약어이고 국내에서는 검색 증강 생성이라 부른다.
2020년 논문에서 나온 이름이고 지금은 대규모 언어모델을 실무에 붙일 때 거의 표준 얼개가 됐다.
동작은 셋이다.
질의를 벡터로 만들고, 그 벡터와 가까운 항목을 데이터베이스에서 고르고, 고른 것을 프롬프트에 넣어 모델에 준다.
모델 가중치를 건드리지 않고 참조만 바꾼다는 점이 요점이다.
이 시리즈는 retrieval을 '조회'로 쓴다.
MeMo 편에서 뱅크의 세 동작을 조회·저장·갱신으로 정해 두었고 이 논문의 동작도 그것이다.
다만 RAG라는 이름을 풀어 쓸 때는 굳어 있는 말인 검색 증강 생성을 쓴다. 이름과 동작을 섞지 않는다.
이 논문이 RAG에서 가져오지 않은 것도 있다.
RAG는 보통 조회한 문서에 순위를 매겨 상위 몇 개를 쓰고 그 개수가 성능을 좌우하는데,
이 논문도 상위 k개를 쓰지만 스트림이 둘이라 실제 개수가 k가 아니다.
2.5가 그 자리다.
2.3 질의를 혼합에서 뽑는다
조회하려면 질의가 있어야 한다. 등록 음성을 질의로 쓰는 것이 자연스러워 보이지만 논문은 그렇게 하지 않는다.
식 (4)의 질의는 지금 들어온 혼합 신호 x_n이다.
이유는 이 얼개가 풀려는 문제에 있다.
등록 음성을 질의로 쓰면 뱅크에서 등록 음성과 닮은 것을 고르게 되고, 그러면 시작할 때의 상태에 계속 묶인다.
목소리가 옮겨 갔는데 옮겨 가기 전의 기준으로 계속 고르는 셈이다.
혼합 신호를 질의로 쓰면 지금 이 순간의 음향 조건과 가까운 것을 고른다.
혼합에는 방해 화자도 섞여 있지만 감정이나 발성 노력 같은 조건은 지금 시점의 것이다.
식 (4)는 유사도에 지수를 씌우고 뱅크 전체로 정규화해 확률 분포를 만든다.
형태는 softmax이고 여기서 나온 확률로 상위 k개를 고른다.
논문이 이 선택을 따로 정당화하지는 않는다. 서술은 한 문장이고 그 뒤로는 이 설계를 전제로 진행한다.
2.4 두 스트림으로 따로 조회한다
조회는 한 번이 아니라 두 번 일어난다.
식 (4)의 attr가 spk와 emo 둘을 오가고, 각각 다른 인코더가 만든 임베딩 위에서 유사도를 잰다.
화자 쪽은 ECAPA-TDNN이 맡는다. 화자 검증에서 널리 쓰는 모델이고 사람의 신원을 벡터 하나로 요약한다.
감정 쪽은 Emotion2vec이 맡고 감정 상태를 요약한다.
둘을 나눈 이유는 두 축이 서로 다른 것을 재기 때문이다.
같은 사람이 화를 낼 때와 차분할 때는 화자 유사도가 높지만 감정 유사도는 낮다.
다른 사람이 같은 감정으로 말하면 반대가 된다.
논문의 문제 설정이 이 분리를 요구한다.
목표는 같은 사람이면서 지금 감정에 가까운 세그먼트를 찾는 것이고,
그 둘을 한 벡터로 뭉개면 어느 쪽이 맞아서 뽑혔는지 알 수 없다.
두 인코더 모두 사전 학습된 것을 그대로 쓰고 동결한다. 이 논문이 학습하는 것은 백본 추출기뿐이다.
2.4.1 ECAPA-TDNN과 Emotion2vec
ECAPA-TDNN은 화자 검증용 임베딩 모델이다.
시간 지연 신경망에 채널 어텐션과 다중 층 특징 집계를 얹은 구조이고,
발화 하나를 고정 길이 벡터로 만들어 두 발화가 같은 사람인지를 코사인 유사도로 판정할 수 있게 한다.
설정 파일이 가리키는 것은 WeSpeaker가 배포한 채널 512짜리 판이고 임베딩은 192차원이다.
Emotion2vec은 음성 감정 표현을 자기지도로 사전 학습한 모델이다.
감정 라벨 없이 대량의 음성으로 학습해 감정 관련 특징을 담은 표현을 만들고, 그 위에서 감정 분류나 유사도 비교를 한다.
이 논문은 분류 라벨을 쓰지 않고 임베딩 사이의 유사도만 쓴다.
둘 다 이 논문이 만든 것이 아니고 학습도 하지 않는다.
조회와 게이트와 축출이 모두 이 둘의 유사도 위에 서므로 이 모델들이 틀리면 셋이 함께 틀리고,
화자 쪽은 식 (8)의 판정까지 맡는다.
한 가지 어긋나는 자리가 있다. 논문은 모든 데이터를 8 kHz로 맞췄다고 적는데 화자 인코더는 16 kHz에서 도는 모델이다.
설정 파일이 그 값을 따로 들고 있고, 논문 본문에는 이 되올림에 대한 서술이 없다.
2.5 조회 결과는 합집합이라 k개가 아니다
식 (5)는 조회 결과를 두 집합의 합집합으로 정의한다.
화자 유사도로 고른 상위 k개와 감정 유사도로 고른 상위 k개를 합치고 중복을 지운다.
그래서 실제로 뽑히는 세그먼트 수는 k가 아니라 k와 2k 사이의 어떤 값이다.
두 스트림이 완전히 같은 것을 고르면 k개가 되고 하나도 겹치지 않으면 2k개가 된다.
논문은 이 사실을 숨기지 않는다.
식 (5) 바로 아래에 실제 개수가 k와 2k 사이에서 변한다고 적고,
뒤의 서술에서는 편의상 이 집합의 크기를 계속 k라 부르겠다고 밝힌다.
정직한 서술이지만 읽을 때 주의가 필요하다.
표 1의 'k=3'은 세 개가 아니라 세 개에서 여섯 개이고, 표 3의 'k=24'는 스물넷이 아니라 스물넷에서 마흔여덟이다.
실제로 몇 개가 뽑히는지는 7.5에서 코드를 돌려 센다.
그리고 이 상한에는 조건이 하나 더 붙는다. 뱅크에 그만큼 들어 있어야 뽑을 수 있다는 것이다.
뱅크 용량이 k보다 작으면 k를 아무리 키워도 뽑히는 것이 늘지 않는다. 3.6과 7.6이 그 자리다.
2.5.1 Top-k와 합집합
Top-k는 점수 순으로 정렬해 위에서 k개를 자르는 흔한 방식이다. 하나의 순위표에서 자르면 결과가 정확히 k개다.
이 논문은 순위표를 둘 만든다.
화자 유사도 순위표와 감정 유사도 순위표이고, 각각에서 위 k개를 자른 다음 두 결과를 합쳐 중복을 지운다.
합집합을 쓰면 어느 한 축에서만 높아도 뽑힌다.
감정은 멀지만 같은 사람인 것이 확실한 세그먼트와, 화자 점수는 애매하지만 지금 감정과 똑같은 세그먼트가 둘 다 들어온다.
교집합을 썼다면 두 조건을 모두 만족하는 것만 남아 훨씬 적게 뽑혔을 것이다.
중복 제거는 같은 세그먼트가 두 순위표에 모두 들면 한 번만 세는 처리다.
이 자리의 중복은 뒤에 나올 축출 점수의 redundancy와 다른 뜻이니 섞지 않는다.
여기서는 같은 항목이 두 번 세어지는 것을 막는 것이고, 축출에서는 뱅크 안 항목들이 서로 얼마나 닮았는지를 재는 것이다.
2.6 등록을 이어 붙여 늘린다
조회한 세그먼트를 어떻게 참조로 바꿀지가 식 (6)이다. 답은 시간축 이어 붙이기다.
초기 등록 음성 r 뒤에 조회한 m_1부터 m_k까지를 차례로 붙여 하나의 긴 파형 r_n을 만든다.
평균이 아니라는 점이 중요하다.
임베딩을 담는 뱅크였다면 벡터 몇 개를 평균해 하나로 만들 수 있지만, 이 뱅크는 파형을 담으므로 그렇게 할 수 없다.
파형의 평균은 소리가 되지 않는다.
이어 붙이면 참조가 길어진다.
등록 음성 하나가 몇 초였다면 조회한 것을 붙인 뒤에는 몇 배가 되고, 그 안에 그 사람의 여러 상태가 들어 있다.
논문의 서술은 초기 등록 r이 신원을 붙들어 두는 자리이고 뒤에 붙는 세그먼트들이 지금의 음향 변화를 싣는다는 것이다.
앞은 고정된 기준이고 뒤는 움직이는 참조라는 구도다.
이 서술이 코드와 맞는지는 따로 봐야 한다.
2.7이 그 자리이고 실제로 만들어지는 파형이 식 (6)이 말하는 것과 같은지는 7.7에서 길이를 재어 본다.
2.7 초기 등록이 맨 앞에 남는다는 서술은 코드에 없다
식 (6)은 r을 항상 맨 앞에 둔다. 수식만 보면 초기 등록이 빠지는 경우가 없고 순서도 고정이다.
저자 구현은 그렇게 하지 않는다.
참조를 만드는 함수에 넘어가는 것은 조회기가 고른 키 목록뿐이고, 그 목록에 초기 등록을 강제로 넣는 처리가 없다.
초기 등록은 다른 후보들과 함께 유사도 계산에 들어가는 항목 하나일 뿐이다.
그러면 두 순위표 어느 쪽에도 못 들 때 초기 등록이 참조에서 빠진다.
세션이 길어져 뱅크가 좋은 세그먼트로 채워질수록 그럴 가능성이 커진다. 신원을 붙들어 두는 고정점이 사라지는 것이다.
순서도 보장되지 않는다.
조회기는 감정 순위표를 먼저 훑고 화자 순위표를 나중에 훑으므로 결과 목록의 앞자리가 초기 등록이라는 보장이 없다.
조각을 잇는 단계는 인덱스 순을 지키므로 흐트러지지 않지만, 무엇이 살아남는지는 그 앞에서 정해진다.
논문이 이 기제에 기대어 설명하는 문장이 한 줄뿐이라 본문만 읽으면 넘어가기 쉽다.
코드를 열면 그 한 줄에 대응하는 것이 없다.
2.8 백본은 화자 임베딩을 쓰지 않는다
논문 2절은 기존 연구를 임베딩 기반과 임베딩 비사용으로 가른다.
앞쪽은 등록 음성에서 화자 벡터를 뽑아 그 벡터로 분리기를 조건화하는 방식이고,
뒤쪽은 등록 파형 자체를 모델에 넣는 방식이다.
이 논문이 백본으로 고른 USEF-TFGridNet은 뒤쪽이다. 등록 파형을 혼합과 같은 방식으로 STFT해 놓고 교차 어텐션으로 섞는다.
모델 안에 화자 벡터라 부를 만한 것이 없다.
이 선택이 앞 절들을 성립시킨다.
임베딩 기반 백본이었다면 세그먼트를 아무리 이어 붙여도 인코더가 벡터 하나로 요약해 버리므로,
여러 상태를 담는다는 발상 자체가 성립하지 않는다.
파형을 그대로 받기 때문에 이어 붙이기가 뜻이 있다.
논문 5.3절이 백본 규격을 여섯 값으로 준다.
STFT 창 길이 16 밀리초와 홉 길이 8 밀리초, 65차원 복소 특징, 출력 채널 128의 2차원 합성곱, 어텐션 헤드 넷,
그리고 512차원이라 적은 FFN이다.
그 여섯 값이 설정 파일과 맞는지 그리고 8 kHz에서 그 밀리초가 몇 표본이 되는지는 7.2에서 환산해 본다.
마지막 하나는 이름이 어긋난다.
3. 게이트가 없으면 뱅크가 스스로 오염된다
3.1 오류가 쌓이는 고리
이 얼개의 위험은 자기 출력을 다시 입력으로 쓴다는 데서 나온다.
n번째에서 방해 화자를 뽑았다고 하면 그 파형이 슬롯에 들어가고, n+1번째는 그것을 참조의 일부로 받는다.
참조에 방해 화자가 섞여 있으면 그다음 추출은 방해 화자 쪽으로 더 기운다.
그 결과가 또 슬롯에 들어가고 몇 걸음 지나면 뱅크가 엉뚱한 사람으로 채워진다.
논문은 이것을 오류 전파라 부르고 논문 4.4절의 첫 문단에서 이 얼개가 감당해야 할 위험으로 든다.
한 번의 실수가 그 자리에서 끝나지 않고 누적된다는 것이 정적 파이프라인과의 결정적인 차이다.
정적 파이프라인에는 이 위험이 없다.
세그먼트마다 독립이므로 한 번 틀려도 다음 세그먼트는 원래 등록 음성으로 다시 시작한다. 틀림이 국소적이다.
그래서 이어지는 추론으로 바꾸는 대가가 이 위험이고, 그 대가를 치를 장치가 신뢰도 분류기다.
3.1.1 self-enrollment와 이 논문
self-enrollment는 추론 중에 자기가 뽑아낸 결과를 다음 등록 음성으로 쓰는 방식이다.
MeMo 편에서 이 개념을 봤고 그 편의 뱅크는 들어오는 추정치를 조건 없이 담았다.
조건이 없다는 것이 이 논문이 겨냥하는 지점이다.
뱅크에 무엇이 들어가는지를 아무도 보지 않으면 오류 전파를 막을 장치가 없다.
이 논문이 더한 것은 담기 전에 신원을 확인하는 판정이다. 논문 4.4절이 그 자리다.
꽉 찼을 때 무엇을 뺄지는 MeMo 편도 선입선출과 어텐션 기반으로 이미 다뤘고, 이 논문은 그 자리를 중복도로 바꾼다.
논문 4.5절이 그것이다.
MoMuSE 편은 다른 자리에 게이트를 두었다.
그 편의 갱신은 임계값을 넘을 때만 일어나되 옛 값을 남기지 않고 통째로 바꾸는 방식이고,
담는 것도 파형이 아니라 화자 임베딩 하나다.
이 편에서는 뱅크에 들어간 잘못된 항목이 참조 파형 안에 소리로 남는다.
3.2 신뢰도는 뱅크 전체와 견준다
식 (8)이 신뢰도 점수를 정의한다. 그림 1의 (c)가 그 판정을 그림으로 놓은 자리다.
새 추정치의 화자 임베딩을 뱅크에 이미 있는 모든 항목과 견주고, 그 코사인 유사도 가운데 최댓값을 점수로 삼는다.
최댓값이라는 점이 설계다.
평균을 쓰면 뱅크에 서로 다른 상태가 섞여 있어 점수가 눌리고,
초기 등록 하나만 보면 상태가 옮겨 갔을 때 아무것도 통과하지 못한다.
하나라도 충분히 닮은 것이 있으면 통과시키는 규칙이다.
식 (9)가 판정이다. 점수가 임계값 τ보다 크면 뱅크에 추가하고 아니면 뱅크를 그대로 둔다.
조건이 한 줄이고 학습되는 파라미터가 없다.
논문이 강조하는 것은 견주는 대상이 초기 등록 하나가 아니라는 점이다.
논문 4.4절 뒷부분이 그 차이를 따로 문단 하나로 설명한다.
이 규칙에는 정의되지 않는 순간이 하나 있다. 뱅크가 비어 있는 첫걸음이다. 3.5가 그 자리다.
3.3 최댓값을 쓰면 다리가 놓인다
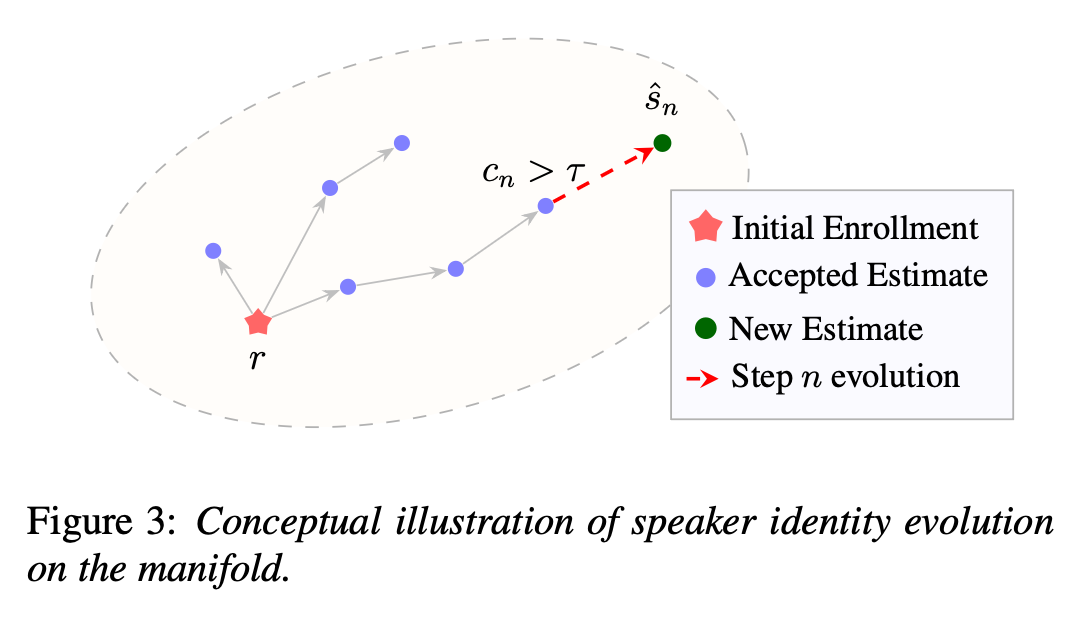
최댓값 규칙의 결과를 논문은 자기 그림 3으로 설명한다. 이 글에서는 그림 2다.
화자 특징 공간에 초기 등록이 한 점으로 있고, 받아들여진 추정치들이 그 주변으로 퍼져 나가는 그림이다.
시작 녹음이 감정적으로 치우쳐 있다고 하자. 차분한 세그먼트는 그 점에서 멀어 바로 통과하지 못한다.
임계값을 넘으려면 초기 등록과 충분히 닮아야 하는데 그렇지 않기 때문이다.
그런데 중간쯤 되는 세그먼트는 통과할 수 있다.
그것이 뱅크에 들어가면 다음 판정에서는 견줄 대상이 하나 늘고, 차분한 세그먼트가 그 중간 항목과 닮아 통과한다.
이렇게 중간 단계를 밟아 가며 뱅크가 넓어진다.
논문은 이것을 다리를 놓는 효과라 부르고,
뱅크가 그 사람의 넓은 발성 범위를 덮게 되면서도 새로 들어오는 것은 매번 신원이 확인된다고 적는다.
이 효과가 최댓값 규칙에서만 나온다는 점을 짚어 둘 만하다.
초기 등록 하나만 견줬다면 다리가 놓이지 않고, 평균을 썼다면 뱅크가 넓어질수록 점수가 눌려 오히려 좁아진다.
3.4 임계값 하나가 9.70 dB를 가른다
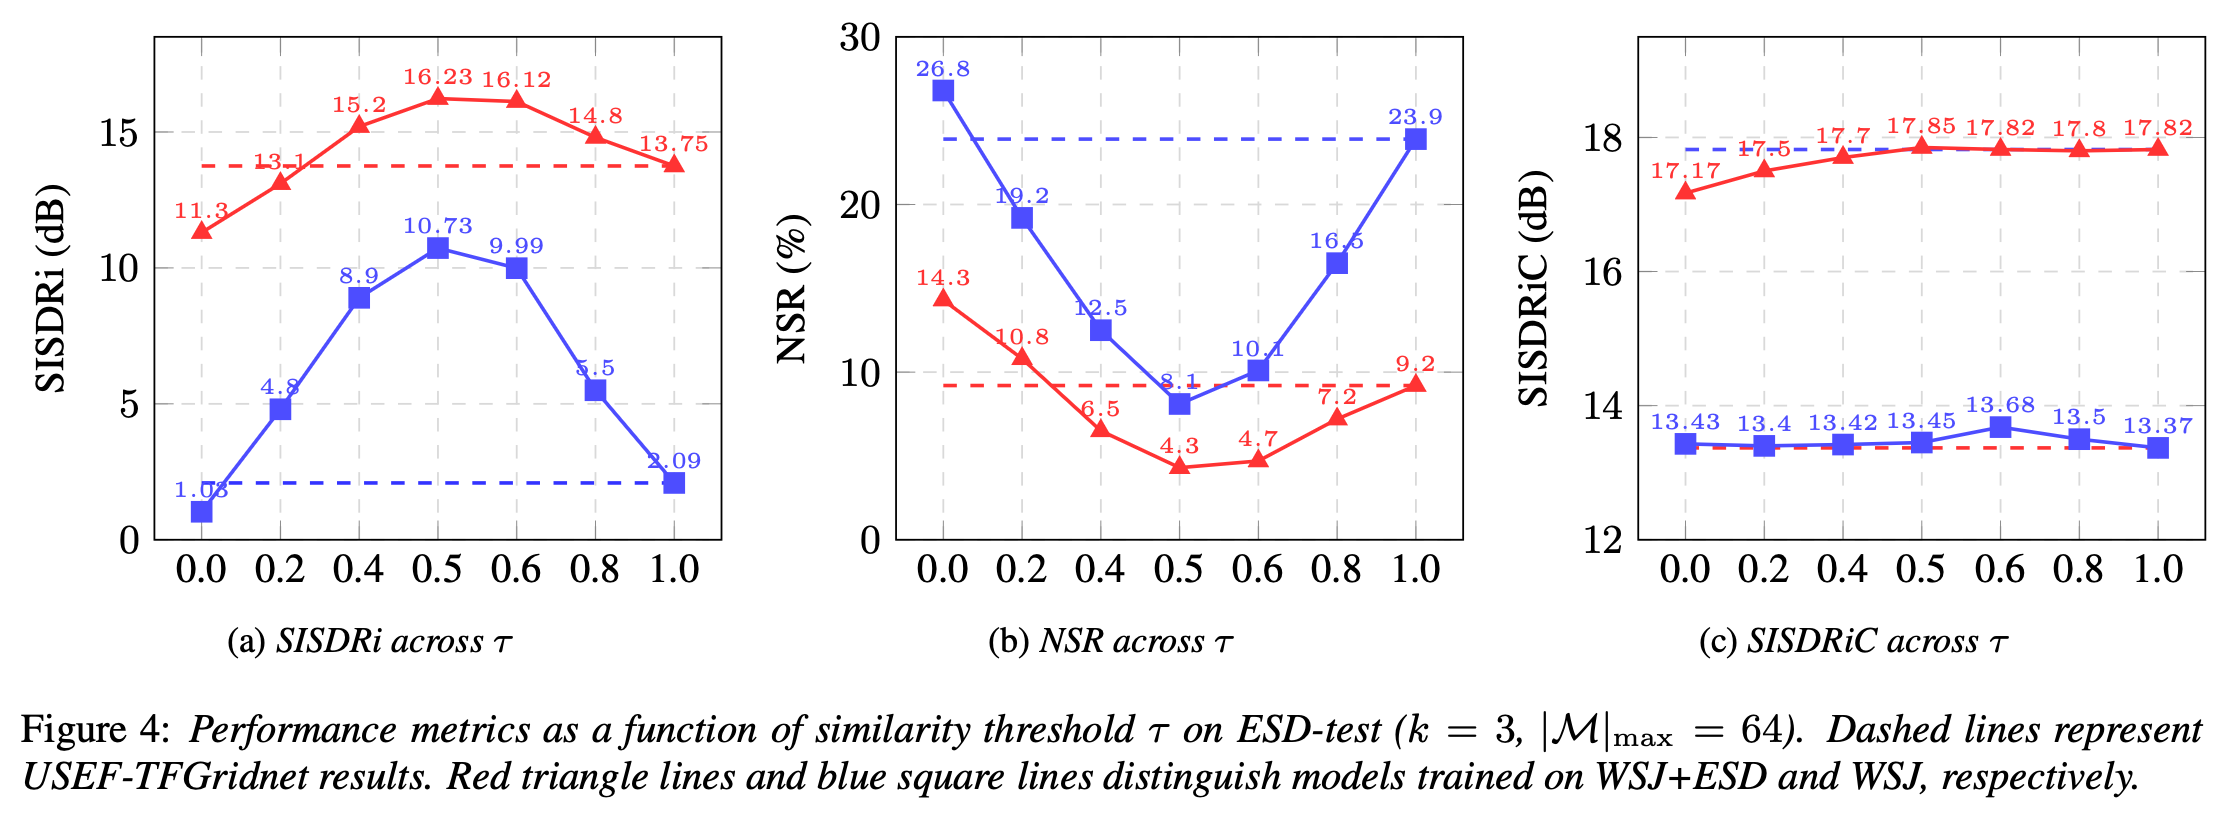
논문 6.4절이 τ를 0.0부터 1.0까지 훑는다. 이 편이 이 논문을 읽는 이유가 그 곡선이다.
τ=0.0이면 게이트가 꺼진다.
모든 추출 결과가 품질과 무관하게 뱅크에 들어가고,
논문은 그 조건에서 WSJ으로 학습한 모델의 SI-SDRi가 1.03 dB로 떨어진다고 적는다.
정적 기준선이 2.09 dB이므로 기준선보다 나쁘다. WSJ+ESD로 학습한 쪽은 NSR이 9.2%에서 14.3%로 오른다.
τ=1.0이면 아무것도 통과하지 못한다.
뱅크가 비어 있으니 참조는 초기 등록 하나뿐이고, 그러면 정적 기준선과 같은 동작이 된다.
논문도 그 끝점이 기준선과 정확히 같다고 적는다.
가장 좋은 값은 0.5다. 그 값에서 WSJ 학습 모델의 SI-SDRi가 10.73 dB, NSR이 8.1%가 된다.
기준선 2.09 dB와 23.9%에서 크게 움직인 값이다.
두 끝점과 최적점을 나란히 놓으면 이 논문의 장치가 무엇을 하는지가 한 줄로 보인다.
게이트를 끄면 1.03이고 켜면 10.73이니 임계값 하나가 9.70 dB를 가른다.
조회도 축출도 그대로 두고 이 조건 한 줄만 바꾼 결과다.
3.5 식 (8)은 첫걸음에서 정의되지 않는다
식 (8)의 최댓값은 뱅크 안의 항목들 위에서 잡힌다. n=1일 때 그 집합은 비어 있고 빈 집합의 최댓값은 없다.
논문은 이 경우를 적지 않는다.
논문 4.4절 전체가 뱅크에 이미 무언가 들어 있는 상황을 전제로 서술되고,
첫 세그먼트를 어떻게 처리하는지에 대한 문장이 없다.
저자 구현은 그 구멍을 메운다.
분류기가 견줄 대상을 모을 때 초기 등록의 화자 임베딩을 먼저 넣고 그다음에 뱅크 항목들을 붙인다.
그래서 뱅크가 비어 있어도 견줄 것이 하나는 있다.
이 처리는 합리적이지만 식 (8)이 말하는 것과 다르다. 식대로면 참조 집합이 뱅크이고 코드에서는 초기 등록을 더한 집합이다.
3.3에서 본 다리 놓기 효과도 이 차이 위에서 시작한다.
같은 자리에서 부등호도 한 칸 어긋난다. 식 (9)는 점수가 임계값보다 커야 통과라 적는데 코드는 크거나 같으면 통과다.
경계에 정확히 걸리는 값에서만 갈리므로 실제로는 거의 드러나지 않는다.
3.6 논문은 슬롯 예순넷, 코드는 열여섯이다
논문 4.5절은 뱅크 용량을 기호로만 적는다. 용량이 있다는 것과 꽉 차면 뺀다는 것만 서술하고 값은 본문에 없다.
값은 논문의 그림 캡션에 있다.
논문 그림 4와 그림 5가 실험 조건을 적으면서 용량을 예순넷으로 밝히고,
논문 6.5절 본문도 조회 개수가 예순넷에 이르면 뱅크 전체를 쓰는 셈이라고 적는다.
배포된 설정 파일은 열여섯이다. EvoTSE 설정 둘 다 그 값이고, 추론 스크립트에는 이 값을 덮어쓸 인자가 없다.
그런데 선택기가 보는 후보는 열일곱이다.
저자 코드가 초기 등록을 뱅크 항목들과 같은 자리에 넣고 정원을 셀 때만 그것을 빼기 때문이다. 조회는 그 열일곱에서 고른다.
이 차이가 6.12와 7.6에서 값으로 나타난다.
논문이 조회 개수를 스물넷과 마흔여덟과 예순넷으로 훑는데, 배포된 설정에서는 그 셋이 모두 같은 집합을 준다.
3.7 축출은 redundancy가 가장 큰 것을 뺀다
뱅크가 꽉 찼을 때 무엇을 뺄지는 논문 4.5절이 정한다. 규칙은 다양성을 지키는 쪽이다.
식 (10)이 각 항목에 점수를 하나씩 매긴다.
그 항목이 뱅크 안의 다른 항목들과 얼마나 닮았는지를 평균한 값이고, 논문은 이것을 redundancy라 부른다.
가장 닮은 것을 뺀다. 어떤 항목이 다른 것들과 두루 비슷하다면 그것을 지워도 뱅크가 덮는 범위가 거의 줄지 않기 때문이다.
가장 오래된 것을 빼는 선입선출과 비교하면 이 규칙이 겨냥하는 것이 분명해진다.
시간이 아니라 정보량을 기준으로 삼는 것이고, 같은 상태가 여러 슬롯을 차지하는 것을 막는다.
MeMo 편이 다룬 어텐션 기반 축출과도 다르다.
그쪽은 지금 입력에 얼마나 쓸모 있는지를 봤고 이쪽은 뱅크 안에서 얼마나 겹치는지를 본다.
질의와 무관하게 정해진다는 점이 특징이다.
3.7.1 redundancy를 무엇으로 재나
식 (10)은 두 유사도를 더한다.
화자 임베딩끼리의 코사인 유사도에 감정 임베딩끼리의 코사인 유사도를 가중치 alpha로 곱해 더하고,
그것을 다른 항목 전부에 대해 평균한다.
alpha 값은 논문에 없다.
식에서 기호로 도입하고 감정과 화자의 영향을 저울질하는 값이라 설명하지만, 실험에서 얼마를 썼는지는 적지 않는다.
저자 구현은 두 축을 각각 0.5로 놓는다.
설정 파일에 그 항목이 없어 모델 클래스의 기본값이 그대로 쓰이고, 결과적으로 화자와 감정을 같은 비중으로 본다.
식과 코드의 모양도 다르다.
식은 항목 쌍마다 두 유사도를 더한 뒤 평균하고, 코드는 두 축을 각각 평균한 뒤 0.5씩 곱해 더한다.
항의 개수가 같고 alpha가 1이라면 코드 값이 식의 절반이 되고, alpha가 다르면 두 축의 비중 자체가 갈린다.
나누는 수는 후보마다 같아서 뺄 것을 고르는 순위는 안 갈리지만,
새 추정치만 한 항목 더 많은 수로 나뉘어 교체할지 버릴지의 비교가 갈린다.
3.8 구현은 새 세그먼트를 버리기도 한다
식 (10)의 서술은 간단하다. 뱅크가 꽉 차면 점수가 가장 높은 항목을 빼고 그 자리에 새 추정치를 넣는다.
논문도 새 추정치의 점수를 기존 항목들과 견준다고 적는다. 코드가 더한 것은 그 견주기의 결말이다.
새 추정치의 점수를 같은 방식으로 계산해 희생자의 점수와 견주고, 새 것이 더 낮을 때만 교체한다.
새 것이 더 높으면 아무것도 빼지 않고 새 것을 버린다.
논문 4.5절은 견주기까지만 적는다.
신뢰도 게이트를 통과해 신원이 확인된 추정치가 뱅크에 못 들어가는 경로이고,
논문 4.4절도 논문 4.5절도 그런 경우를 서술하지 않는다.
의도는 짐작할 수 있다. 새 것이 기존 것들과 더 많이 겹친다면 넣어 봐야 다양성이 줄기 때문이다.
다만 그 판단의 결말이 논문에는 없고, 게이트가 두 겹이 되는 셈이다.
얼마나 자주 밟히는지는 7.8에서 센다. 뱅크가 꽉 찬 상태로 예순 번 돌리면 세 번 밟힌다. 드물지만 존재하는 경로다.
3.9 식 (10)과 코드가 갈리는 세 자리
앞 절의 폐기 분기 말고도 셋이 더 있다. 값을 크게 바꾸지는 않지만 식을 그대로 읽으면 코드와 다른 것을 얻는다.
첫째는 나누는 수다. 식은 용량에서 하나를 뺀 수로 나누고 코드는 실제로 견준 항목 수로 나눈다.
뱅크가 꽉 차 있으면 두 값이 같지만 덜 차 있으면 다르다.
둘째는 모집단이다. 식은 뱅크 안의 항목들끼리만 견주는데 코드는 초기 등록을 그 목록에 넣는다.
3.5에서 본 것과 같은 처리이고 여기서는 점수의 분모와 분자에 모두 영향을 준다.
셋째는 가중치다. 식은 화자 항의 계수를 1로 두고 감정 항에만 alpha를 곱하는데, 코드는 두 축을 모두 0.5로 곱한다.
순위만 놓고 보면 alpha가 1일 때와 같지만 점수의 절댓값은 절반이다.
셋 다 순위를 크게 흔들지는 않는다. 그래도 적어 두는 이유는 이 편이 읽는 것이 바로 이 규칙이기 때문이다.
뱅크에 무엇을 남길지 정하는 식을 옮겨 쓸 사람은 이 세 자리에서 코드를 봐야 한다.
4. 학습을 추론과 같은 모양으로 맞춘다
4.1 두 단계로 나눈 이유
추론이 순차 처리로 바뀌면 학습도 그에 맞춰야 한다.
짝 하나씩 보고 배운 모델을 순차로 굴리면 학습 때 본 적 없는 입력을 받게 되기 때문이다.
논문의 방식은 두 단계다. 1단계는 보통의 목표 화자 추출 학습이다.
혼합과 등록 음성의 짝을 주고 목표 신호를 맞추게 해서 기본적인 분리 능력을 세운다.
2단계가 순차 학습이다.
1단계에서 나온 가중치로 시작해 세그먼트 묶음 단위로 다시 학습하고,
묶음 안에서는 모델이 앞 걸음의 결과로 만든 참조를 받는다.
1단계를 따로 두는 이유를 논문은 수렴 속도로 든다.
기본 능력을 먼저 세워 두면 뒤이은 순차 학습이 훨씬 빨리 수렴한다는 서술이고,
그것을 빼면 어떻게 되는지를 재는 절제 실험은 논문에 없다.
이 순서가 이 논문의 두 번째 장치다.
게이트가 뱅크를 지키는 장치라면 이쪽은 모델이 뱅크를 쓸 줄 알게 만드는 장치이고,
6.13에서 보겠지만 둘 중 하나만으로는 서지 않는다.
4.2 2단계는 묶음이 그래디언트의 단위다
식 (11)이 2단계의 손실을 적는다. 묶음 안의 세그먼트마다 손실을 구해 전부 더하고 배치 크기와 묶음 크기로 나눈다.
입력의 모양도 함께 적혀 있다. 혼합과 목표가 배치·묶음·시간의 3차원이고 초기 등록은 배치·시간의 2차원이다.
묶음 하나가 그래디언트를 계산하는 최소 단위다.
논문이 이 구성에 붙이는 설명은 묶음 전체를 거쳐 역전파한다는 것이다.
그렇게 하면 모델이 왜곡된 참조에서도 신원을 뽑아내는 법을 배운다고 적는다.
저자 구현에서는 두 자리가 그 서술과 다르다. 하나는 묶음을 만드는 방식이다.
논문은 연속한 세그먼트를 묶는다고 적는데 코드는 그 화자의 목록에서 무작위로 뽑는다.
순서가 없으므로 시간에 따라 목소리가 옮겨 가는 상황이 학습에 재현되지 않는다.
다른 하나는 역전파 경로다. 뱅크에 파형을 저장할 때 계산 그래프에서 떼어 내므로 걸음 사이로 그래디언트가 흐르지 않는다.
묶음 단위의 역전파는 돌지만 걸음을 잇는 경로가 끊겨 있어, 논문이 적은 이어지는 전체를 거친 역전파는 구현에 없다.
4.3 추출기가 만든 artifact를 학습에 넣는다
순차 학습이 실제로 무엇을 바꾸는지는 참조의 성질을 보면 드러난다.
1단계에서 모델이 본 참조는 사람이 녹음한 깨끗한 음성이다. 순차 학습에서 모델이 받는 참조는 자기가 뽑아낸 음성이다.
신경망 추출기의 출력에는 미세한 왜곡이 남는다.
사람 귀에는 같은 사람으로 들려도 신호로 보면 원본과 다르고, 그 차이가 화자 임베딩에도 나타난다.
깨끗한 참조만 보고 학습한 모델은 이 왜곡이 섞인 참조를 받으면 성능이 떨어진다.
논문은 이것을 artifact에 대한 강건성 문제로 부르고, 2단계 학습의 두 번째 목적으로 든다.
해법은 그 왜곡을 학습에 넣는 것이다.
순차로 돌리면 모델이 받는 참조가 자기 출력이므로 왜곡이 자연스럽게 입력에 들어오고,
모델은 왜곡된 참조에서도 신원을 뽑아내는 법을 배운다.
논문은 이 전략을 artifact-aware learning이라 이름 붙인다.
이름이 가리키는 것은 왜곡을 없애는 것이 아니라 왜곡이 있다는 전제로 학습한다는 뜻이다.
4.3.1 curriculum learning과 scheduled sampling
curriculum learning은 쉬운 것부터 어려운 것 순으로 학습 자료를 배열하는 방식이다.
사람이 배우는 순서를 흉내 낸 것이고, 처음부터 어려운 표본을 주면 수렴이 느리거나 실패한다는 관찰에서 나왔다.
scheduled sampling은 시퀀스 모델을 학습할 때 정답을 넣을지 모델 출력을 넣을지를 확률로 섞는 방식이다.
학습 초기에는 정답을 많이 넣고 점점 모델 출력의 비율을 올린다.
두 방식이 겨냥하는 문제는 같다.
학습할 때는 정답을 받다가 추론할 때는 자기 출력을 받으면 그 차이가 오차로 누적된다는 것이다.
AV-SkiM 편에서 exposure bias라는 이름으로 이 문제를 다뤘다.
이 논문의 2단계 학습은 그 계열에 있지만 확률로 섞지 않는다.
1단계에서는 전부 사람이 녹음한 참조를 쓰고 2단계에서는 초기 등록 뒤에 자기 출력을 이어 붙인 참조를 쓴다.
두 단계 사이에 단절이 있는 구성이다.
논문이 이 전략을 curriculum learning이라 부르는 자리는 논문 5.3절의 학습 절차 서술이다.
배열이 두 칸뿐이라 곡선이라기보다 계단에 가깝다.
4.4 기준선도 같은 스텝만큼 더 학습한다
2단계를 붙이면 EvoTSE는 기준선보다 더 오래 학습한 모델이 된다.
그 상태로 비교하면 성능 차이가 얼마나 학습량에서 오는지 알 수 없다.
논문은 그 자리를 막는다. 기준선도 같은 수의 스텝만큼 정적 방식으로 미세조정한다고 논문 5.3절에 적는다.
값은 2에폭이다.
1단계가 최대 150에폭인 것에 비하면 아주 짧고, 그래서 2단계는 새로 배우는 단계라기보다 추론 모양에 맞추는 단계에 가깝다.
이 장치가 있어서 표 1의 비교가 성립한다.
기준선의 정적 행과 EvoTSE 행이 같은 학습량 위에 있고, 그 위에서 갈리는 것이 참조를 바꾸는 기제의 몫이다.
다만 6.13에서 보겠지만 2단계를 아예 빼면 결과가 뒤집힌다. 같은 학습량을 맞추는 것과 순차 학습을 하는 것은 다른 문제다.
4.5 config가 적는 학습 조건
논문 5.3절이 1단계 조건을 셋으로 적는다.
최대 150에폭, 초기 학습률 0.0005, 검증 손실이 3에폭 연속 정체하면 절반으로 줄이는 것이다.
설정 파일과 대조하면 셋 중 하나만 맞는다. 학습률 감쇠는 정확히 일치한다.
학습 스크립트가 감쇠 계수 0.5에 인내 3으로 스케줄러를 세우고, 논문 문장과 두 값이 모두 같다.
나머지 둘은 갈린다. 학습률이 설정 파일에서는 0.0001이라 논문 값의 5분의 1이고, 에폭 상한은 200이라 논문의 150보다 크다.
2단계 설정도 두 모델이 서로 다르다. 묶음 크기가 WSJ 쪽은 여덟이고 WSJ+ESD 쪽은 열이다.
같은 논문의 두 행이 다른 길이의 묶음으로 학습된 것이다.
갈리는 것이 하나 더 있다.
조회한 파형에서 조각을 고르는 비율이 WSJ 쪽은 0.5이고 WSJ+ESD 쪽은 1.0이라
7.7에서 보겠지만 두 모델이 등록 음성을 다른 길이로 만든다.
나머지는 두 설정이 같다. 배치 크기 1에 그래디언트 누적 8, 세그먼트 길이 1.8초, warmup 1만 스텝이다.
배치가 1이고 누적이 8이므로 실효 배치는 여덟 묶음이다.
4.6 논문에 없고 코드에만 있는 전처리가 둘이다
첫째는 무음 제거다.
설정 파일이 그것을 켜 두고 프레임 길이 25 밀리초와 이동 10 밀리초, 에너지 문턱 비율 0.1,
최소 유성 구간 50 밀리초를 함께 적는다.
논문 본문에는 이 처리에 대한 서술이 없다.
무음을 빼면 등록 음성의 길이가 달라진다.
조회로 붙이는 세그먼트도 같은 처리를 거치므로, 식 (6)이 만드는 참조의 실제 길이는 논문에서 읽을 수 없다.
둘째가 더 크다. 초기 등록을 그대로 쓰지 않고 추출기에 한 번 통과시킨 뒤 쓴다.
설정 파일의 항목 하나가 그 동작을 켜고, 뱅크의 초기 항목과 모든 유사도가 그 출력 위에서 계산된다.
이것은 2.7과 3.5의 서술을 다시 보게 만든다.
초기 등록이 신원을 붙들어 두는 고정점이라는 구도였는데,
그 고정점부터 모델이 만든 것이고 4.3이 말한 왜곡이 이미 들어 있다.
논문이 이 처리를 적지 않는 것은 서술의 구멍이다.
artifact에 강건하게 만드는 것이 2단계 학습의 목적인데,
그 왜곡이 참조의 출발점에도 들어 있다는 사실은 설계의 일부이지 세부가 아니다.
5. 실험은 감정이 흔드는 자리를 겨냥한다
5.1 WSJ0-2mix가 기본 학습·평가 집합이다
WSJ0-2mix는 음성 분리 연구에서 가장 오래 쓰인 벤치마크다.
월스트리트저널 낭독 음성을 둘씩 섞어 만들고, 학습에 101명의 발화 2만 개, 검증에 같은 101명의 5천 개,
평가에 학습에 없던 18명의 3천 개를 쓴다.
논문이 이 데이터를 고른 이유는 백본을 따라간 것이다.
USEF-TFGridNet이 이 설정으로 보고했으므로 같은 자리에서 비교해야 백본을 바꾸지 않았다는 것이 성립한다.
이 데이터의 성질은 조용하다. 낭독 음성이라 감정 변화가 거의 없고 녹음 조건도 일정하다.
한 화자의 목소리가 세션 안에서 옮겨 가는 상황이 잘 나타나지 않는다.
그래서 이 데이터만으로는 이 논문이 겨냥한 문제가 드러나지 않는다.
표 1의 WSJ0-2mix 열에서 EvoTSE와 기준선의 차이가 작은 것이 그 때문이고, 논문도 그 사실을 감추지 않는다.
Libri2mix-clean이 셋째 열로 들어온다. LibriSpeech에서 만든 혼합이고 겹치지 않는 40명의 3천 혼합을 평가에 쓴다.
학습에 쓰지 않으므로 이 열이 도메인 밖 성능을 재는 자리다.
5.1.1 WSJ0-2mix와 Libri2Mix
WSJ0-2mix는 2016년 딥 클러스터링 논문이 만든 혼합 데이터다.
WSJ0 낭독 코퍼스에서 발화를 골라 0에서 5 데시벨 사이에서 고른 비율로 둘씩 섞고, 평가 화자를 학습에서 완전히 빼 놓았다.
Libri2Mix는 2020년에 나왔고 LibriSpeech를 바탕으로 같은 방식을 쓴다.
낭독이라는 점은 같지만 화자가 훨씬 많고 녹음 환경이 다양하며, 잡음을 섞은 판과 안 섞은 판이 따로 있다.
두 데이터의 관계는 이 논문에서 학습과 평가로 갈린다.
WSJ0-2mix로 학습한 모델을 Libri2mix-clean으로 평가하므로, 그 열의 값은 학습 도메인 밖에서 얼마나 버티는지를 나타낸다.
혼합 방식에도 갈래가 있다.
짧은 쪽에 맞춰 자르는 min과 긴 쪽에 맞춰 늘리는 max인데, 설정 파일이 경로로 든 것은 전부 min 쪽이다.
Libri2mix는 설정 파일이 아니라 추론 스크립트의 분기에 있고 그쪽은 max를 쓴다.
5.2 데이터셋마다 세는 기준이 다르다
저장소가 든 목록을 직접 세면 논문 숫자와 어긋나는 자리가 있다.
학습 목록은 화자 101명에 4만 줄, 검증은 1만 줄, 평가용 tt는 18명에 6천 줄이다. 논문이 적은 2만·5천·3천의 정확히 두 배다.
두 배인 이유는 이 과제의 성질이다.
목표 화자 추출은 혼합 하나를 두 화자 각각에 대해 한 번씩 세므로, 혼합 3천 개가 항목 6천 개가 된다.
그런데 실제 평가에 쓰는 목록은 5,982다. 6천에서 18이 빠졌고 그 18은 화자 수와 같다.
우연이 아니다. 화자마다 tt 목록에서 빠진 항목을 찾아 그 화자의 등록 uid와 견주면 18명 전원에서 정확히 일치한다.
화자마다 하나를 등록 음성으로 빼내고 나머지를 평가에 쓴 것이다.
ESD와 Libri2mix는 두 배가 아니다. 각각 4,986과 3,000으로 논문 숫자 그대로다. Libri2mix가 한 배인 이유는 논문이 적는다.
혼합마다 Source 1만 목표로 쓴다는 것이고 WSJ의 두 배와 ESD의 한 배에는 그런 문장이 없다.
세 데이터셋이 서로 다른 기준으로 세어져 있으므로 표 1의 세 열을 나란히 읽을 때 이 차이를 알고 봐야 한다.
5.3 ESD가 감정 축을 더한다
WSJ0-2mix와 Libri2mix로는 이 논문이 풀려는 문제가 나타나지 않는다.
둘 다 낭독이라 목소리가 세션 안에서 크게 옮겨 가지 않기 때문이다.
그래서 감정 음성 데이터베이스를 들여온다.
ESD는 감정 음성 변환 연구에서 만든 데이터이고 화자마다 다섯 감정의 발화가 들어 있다.
논문은 그것으로 혼합 집합을 새로 만든다.
평가 집합이 4,986 혼합이고 화자는 남녀 둘씩 넷이며, 화남·기쁨·중립·슬픔·놀람 다섯 상태를 덮는다.
나머지 데이터는 WSJ0-2mix와 같은 방식으로 섞어 학습 집합으로 쓴다.
화자가 넷뿐이라는 점이 이 집합의 성질을 정한다.
평가 혼합 4,986개가 화자 넷에 몰려 있으므로 화자 하나가 이끄는 세션이 매우 길어진다.
이 데이터에서 표 1과 표 2의 큰 차이가 나온다.
도메인 밖 조건에서 기준선이 무너지고 EvoTSE가 버티는 자리가 여기이고,
시작 등록 음성의 감정을 바꿔 보는 표 2도 이 집합 위에서 잰다.
5.3.1 ESD와 감정 라벨
ESD는 Emotional Speech Database의 약어이고 2021년과 2022년에 두 편으로 발표됐다.
감정 음성 변환을 위해 만들어졌고 중국어와 영어 화자가 같은 문장을 다섯 감정으로 읽은 병렬 코퍼스다.
감정이 라벨로 붙어 있다는 점이 이 논문에 쓸모 있다.
같은 화자의 같은 문장이 감정만 다르게 녹음돼 있으므로,
화자는 같은데 음향 특징이 멀어지는 상황을 라벨로 통제해 만들 수 있다.
이 논문은 라벨을 한 곳에 쓴다. 시작 등록 음성을 특정 감정에서 고르는 자리다.
표 2의 다섯 행은 평가 혼합을 가른 것이 아니라 같은 4,986개를 그대로 두고 등록 음성만 바꾼 것이고,
저장소의 감정별 목록 서른도 혼합 목록이 전부 같고 등록 uid만 다르다.
감정마다 등록 조합이 둘씩이라 표 2의 다섯 행이 어느 쪽으로 나온 값인지는 저장소만으로 정해지지 않는다.
조회에는 라벨을 쓰지 않는다.
Emotion2vec이 만드는 임베딩끼리의 유사도만 쓰므로, 학습이든 추론이든 감정 이름을 아는 상태로 도는 것이 아니다.
라벨이 실험 설계에만 쓰인다는 점은 이 얼개가 실제 배포에서 어떻게 도는지를 생각할 때 중요하다.
감정 라벨이 없는 환경에서도 같은 기제가 돌 수 있다는 뜻이다.
5.4 지표 셋을 갈라 쓴다
논문은 지표를 셋 쓴다. 하나만 보면 이 논문이 무엇을 고쳤는지가 흐려지기 때문이다.
SI-SDRi는 전체 품질이다.
추출한 신호가 혼합보다 얼마나 나아졌는지를 데시벨로 재고 이 계열 논문이 관행적으로 첫 열에 놓는다.
NSR은 화자 혼동이다.
개선치가 음수인 세그먼트의 비율이고,
목표 화자 대신 방해 화자를 뽑으면 개선치가 음수가 되므로 그 비율이 잘못 잡은 비율의 근사가 된다.
SI-SDRiC은 그 둘을 떼어 놓는다. 혼동이 일어나지 않은 세그먼트만 골라 그 부분집합에서 개선치를 평균한다.
목표 화자를 제대로 잡았을 때 백본이 얼마나 잘 뽑는지를 보는 값이다.
세 값을 함께 보면 이 논문의 성격이 드러난다.
6번 섹션에서 보겠지만 SI-SDRi와 NSR은 크게 움직이고 SI-SDRiC은 거의 그대로다.
분리 능력이 아니라 누구를 분리할지가 바뀐 것이다.
5.4.1 SDR과 SI-SNR과 개선치의 i
SDR은 추출한 신호에 남은 목표 성분과 그 밖의 모든 것의 비율이다.
분모에 방해 화자와 잡음과 인공물이 함께 들어가고 값이 클수록 좋다.
SI-SNR은 크기 불변으로 만든 것이다.
추출 신호에 상수를 곱해도 값이 달라지지 않도록 추출 신호를 목표 방향으로 사영해 그 성분을 목표로 삼고 재므로,
모델이 출력 크기를 맞추지 못해 손해 보는 일이 없다.
SI-SDR도 같은 처리이고 이 계열에서 두 이름이 섞여 쓰인다.
개선치의 i는 improvement다. 추출 신호의 값에서 혼합 신호의 값을 빼서, 모델이 더한 몫만 남긴다.
혼합이 이미 좋은 조건이면 절댓값이 높아도 개선치는 작을 수 있다.
이 논문의 세 지표가 모두 개선치 계열이다. SI-SDRi와 SI-SDRiC이 그렇고 NSR은 그 개선치의 부호를 세는 값이다.
앞 편들이 세워 둔 정의를 그대로 쓰면 이 편의 표를 읽을 수 있다.
다만 NSR과 SI-SDRiC은 저자가 정의를 코드에서 다르게 구현한 자리가 있어 5.5와 5.6에서 따로 본다.
5.5 NSR이 재는 것
논문 5.2절의 정의는 한 줄이다.
추출한 세그먼트 가운데 SI-SDRi가 음수인 것의 비율이고, X-TaSNet이 쓴 정의를 그대로 따랐다고 밝힌다.
이 정의가 성립하는 이유는 실패의 모양에 있다.
방해 화자를 뽑으면 추출 신호가 목표와 거의 무관해지므로 개선치가 0 아래로 떨어지고, 제대로 뽑으면 양수가 된다.
부호 하나가 성공과 실패를 가른다.
저자 구현은 다르게 센다.
평가 스크립트가 추출 신호와 목표의 유사도를 방해 화자와의 유사도와 견주고, 앞쪽이 클 때만 성공으로 친다.
개선치의 부호가 아니라 두 후보 가운데 어느 쪽에 가까운지를 보는 방식이다.
같은 스크립트에 세 번째 정의도 남아 있다. 값이 1을 넘는지로 가르는 분기가 따로 있고 그 평균을 따로 낸다.
셋 중 어느 것이 표 1의 NSR을 만들었는지는 저장소만으로 정해지지 않는다.
정의가 갈리면 값도 갈리므로 표의 NSR을 다른 논문의 NSR과 나란히 놓을 때는 이 자리를 알고 봐야 한다.
5.6 SI-SDRiC이 재는 것
SI-SDRiC은 조건부 평균이다.
화자 혼동이 없었던 세그먼트만 골라 그 부분집합에서 개선치를 평균하고,
논문은 그것을 목표 화자를 제대로 잡았을 때의 잠재 성능이라 부른다.
이 값이 필요한 이유는 SI-SDRi가 두 가지를 섞어 재기 때문이다.
잘못 잡아서 음수가 된 세그먼트와 제대로 잡았지만 덜 뽑아낸 세그먼트가 같은 평균에 들어간다.
그 둘을 떼면 무엇이 개선됐는지가 보인다.
문제는 부분집합이 방법마다 다르다는 것이다.
혼동이 적은 방법일수록 더 많은 세그먼트가 평균에 들어가고, 그중에는 어려운 세그먼트도 섞여 있다.
그래서 SI-SDRiC이 높다는 것과 그 방법이 낫다는 것이 곧바로 이어지지 않는다.
모집단이 다르면 평균끼리의 비교가 성립하지 않기 때문이고, 6.10에서 이 성질이 실제로 문제가 되는 자리를 본다.
그리고 앞 절에서 본 대로 어느 세그먼트가 부분집합에 드는지는 NSR의 정의가 정한다.
그 정의가 논문과 코드에서 갈리므로 이 지표의 모집단도 함께 갈린다.
5.6.1 조건부 평균은 무엇을 비교할 수 없게 하나
모집단이 고정된 평균은 비교할 수 있다. 같은 세그먼트 3천 개에서 두 방법의 평균을 내면 차이가 곧 성능 차이다.
조건부 평균은 그렇지 않다.
방법 A가 세그먼트 2,400개에서 평균을 내고 방법 B가 2,900개에서 낸다면, B의 평균에는 A가 아예 포기한 500개가 들어 있다.
그 500개가 어려운 세그먼트라면 B의 평균은 그만큼 눌린다.
더 많이 성공한 방법이 조건부 평균에서는 더 낮게 나올 수 있다는 뜻이다.
이것은 지표의 결함이 아니라 성질이다. 논문도 이 값을 절대 비교가 아니라 안정성을 보이는 데 쓴다.
여러 방법의 SI-SDRiC이 비슷하다는 것이 백본이 그대로라는 근거가 되는 방식이다.
다만 순위를 매기는 데 쓰면 곤란해진다.
6.10에서 EvoTSE가 이 열에서 지는데, 그것을 성능이 낮다고 읽으면 안 되는 이유가 이 성질이다.
그리고 그 자리에서 논문 본문의 표현이 한 걸음 앞서 나간다.
5.7 추론 모드가 셋이다
논문은 비교를 위해 추론 방식을 셋 세운다. 셋의 차이는 등록 음성을 어떻게 주느냐 하나다.
Standard는 관행적인 방식이다. 세그먼트마다 그 화자의 발화 중 하나를 무작위로 골라 등록 음성으로 쓴다.
세그먼트끼리 아무 관계가 없다.
Static은 묶음을 만든다. 화자별로 세그먼트를 모으고 그 묶음 전체에 같은 등록 음성 하나를 쓴다.
EvoTSE와 같은 조건에서 시작하되 갱신을 하지 않는 설정이다.
EvoTSE는 거기에 갱신을 붙인다. 같은 묶음 구성에 조회와 뱅크 갱신이 더해진다.
다만 표 1에서 두 행이 갈리는 것은 추론 방식만이 아니다.
기준선은 정적 방식으로, EvoTSE는 순차로 같은 스텝만큼 미세조정하므로 가중치도 다르다.
이 셋을 갈라 두는 것이 이 논문의 비교 설계에서 가장 중요한 부분이다.
Standard와 Static의 차이는 프로토콜 몫이고 Static과 EvoTSE의 차이가 이 논문 몫이므로, 6.5에서 그 둘을 나눠 볼 수 있다.

그 묶음이 얼마나 긴지는 저장소의 목록을 직접 세면 나오고,
그림 4가 평가 집합 셋의 최단과 최장을 슬롯 수와 함께 놓은 것이다.
WSJ0-2mix가 화자당 316에서 354, ESD가 1,228에서 1,274, Libri2mix가 19에서 134다.
슬롯은 열여섯이다.
ESD의 가장 짧은 세션도 천 개가 넘는 세그먼트를 열여섯 칸에 밀어 넣는다는 뜻이고,
축출 규칙과 폐기 분기가 뜻을 얻는 자리가 이 압력이다.
5.8 8 kHz인데 화자 인코더는 16 kHz다
논문 5.1절은 모든 데이터를 8 kHz로 맞췄다고 적는다.
백본이 그 표본화율에서 돌기 때문이고, STFT 규격도 그 위에서 정해진다.
그런데 조회와 신뢰도 판정에 쓰는 화자 인코더는 16 kHz 모델이다.
설정 파일이 그 값을 따로 들고 있고, WeSpeaker가 배포한 ECAPA-TDNN이 그 표본화율에서 학습됐다.
그러면 8 kHz 파형을 16 kHz로 되올려 인코더에 넣어야 한다.
되올린 신호에는 원래 없던 대역이 채워지지 않으므로 인코더가 학습 때 본 것과 다른 입력을 받는다.
논문 본문에는 이 처리에 대한 서술이 없다. 표본화율을 맞췄다는 문장과 인코더 이름만 있고 그 사이의 변환은 적혀 있지 않다.
값에 얼마나 영향을 주는지는 이 글이 재지 못한다.
평가에 쓰인 8 kHz 혼합이 없어 같은 입력으로 임베딩을 만들어 볼 수 없기 때문이고,
다만 조회와 게이트가 모두 이 임베딩에 의존한다는 점은 적어 둘 만하다.
5.9 WSJ+ESD는 검증 목록이 평가 목록이다
설정 파일 넷 가운데 둘에서 검증 경로와 평가 경로가 같은 파일을 가리킨다.
WSJ+ESD로 학습하는 EvoTSE와 기준선 둘 다 그렇다.
학습 스크립트는 그 목록으로 검증 손실을 계산한다. 그리고 검증 손실이 가장 낮은 시점의 가중치를 체크포인트로 고른다.
그러면 모델을 고르는 기준이 평가에 쓰는 데이터가 된다.
학습 자체는 그 데이터를 보지 않지만 어느 시점의 모델을 남길지는 그것이 정한다.
WSJ 전용 설정 둘은 그렇지 않다. 학습과 검증과 평가가 각각 다른 목록이고, 검증은 학습 화자 101명의 별도 발화다.
표 1과 표 2와 표 3과 표 4의 WSJ+ESD 행이 전부 이 조건 위에 있다.
그 행들의 절댓값을 다른 논문과 나란히 놓을 때는 이 자리를 알고 봐야 하고,
같은 표 안에서 EvoTSE와 기준선을 견주는 것은 둘이 같은 조건이므로 그대로 성립한다.
6. 표는 화자 혼동이 줄었다고 말하고 품질이 늘었다고는 말하지 않는다
6.1 표 1을 읽는 순서
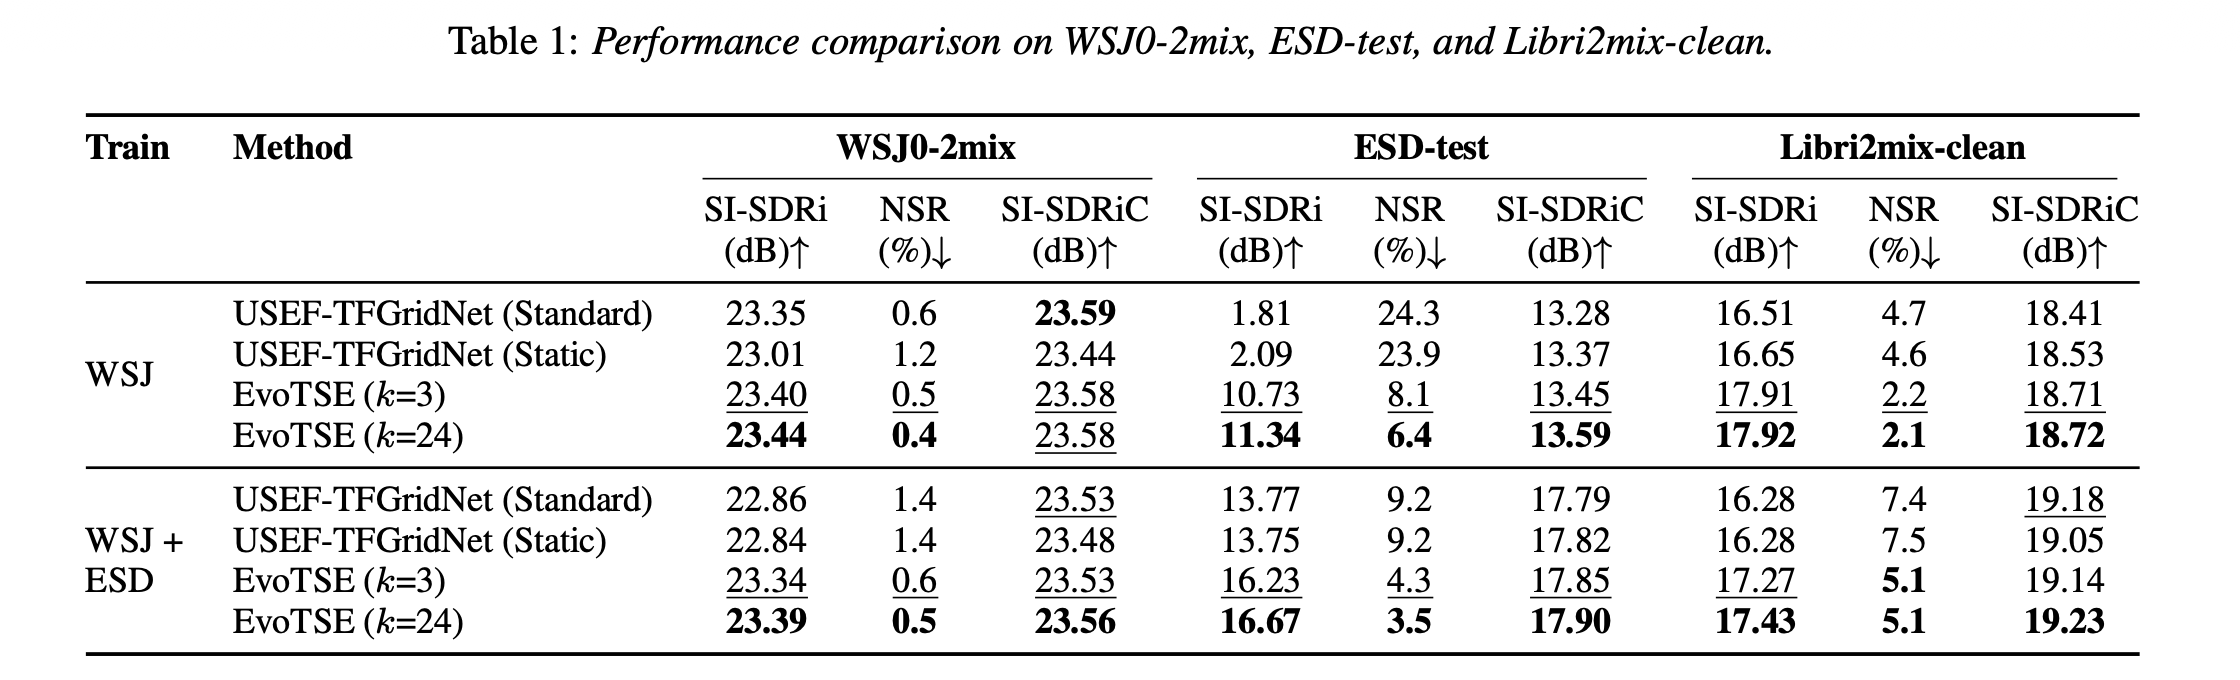
표 1은 세 축이 겹쳐 있어 한 번에 읽기 어렵다.
학습 집합 둘에 추론 방식 넷이라 여덟 행이고, 평가 집합 셋에 지표 셋이라 아홉 열이라 데이터 칸이 일흔둘이다.
세로가 학습이다. 위 네 행이 WSJ만으로 학습한 모델이고 아래 네 행이 WSJ와 ESD를 함께 쓴 모델이다.
가로가 평가다.
왼쪽 세 열이 WSJ0-2mix, 가운데가 ESD-test,
오른쪽이 Libri2mix-clean이고 각 덩어리 안에서 SI-SDRi와 NSR과 SI-SDRiC이 차례로 온다.
각 학습 설정 안의 네 행이 추론 방식이다. Standard와 Static이 기준선 둘이고 EvoTSE가 둘인데 조회 개수만 다르다.
도메인 안과 밖을 가르면 읽기가 쉬워진다.
WSJ으로 학습해 WSJ으로 평가하는 것이 도메인 안이고, WSJ으로 학습해 ESD나 Libri2mix로 평가하는 것이 도메인 밖이다.
논문이 강조하는 자리가 뒤쪽이다.
6.2 OOD에서 벌어지는 폭이 가장 크다
WSJ으로 학습한 모델을 ESD로 평가하면 기준선이 무너진다. 정적 방식의 SI-SDRi가 2.09 dB이고 NSR이 23.9%다.
네 세그먼트 중 하나꼴로 엉뚱한 화자를 뽑는다는 뜻이다.
EvoTSE는 같은 조건에서 10.73 dB에 8.1%가 된다. 입력은 같고 갈리는 것은 둘이다.
추론에서 등록 음성을 갱신한다는 것과, 그 방식에 맞춰 순차로 미세조정한 가중치를 쓴다는 것이다.
더 눈에 띄는 비교가 있다. WSJ만 학습한 EvoTSE의 NSR 8.1%가 ESD를 함께 학습한 기준선의 9.2%보다 낮다.
감정 데이터를 학습에 넣는 것보다 이 얼개를 붙이는 쪽이 더 효과가 컸다는 뜻이다.
Libri2mix에서도 같은 방향이다. 정적 방식이 16.65 dB인데 EvoTSE가 17.91 dB이고 NSR은 4.6%에서 2.2%로 떨어진다.
폭은 ESD보다 작다.
폭이 갈리는 데는 더 단순한 설명이 먼저 있다.
Libri2mix에서는 기준선의 NSR이 이미 4.6%라 고칠 혼동 자체가 ESD의 23.9%에 견주면 5분의 1이다. 여지가 작으니 폭도 작다.
낭독이라 목소리가 덜 옮겨 간다는 설명도 가능하지만 표만으로는 둘을 가르지 못한다.
6.2.1 인과 설정과 온라인 평가 모드
인과 설정은 지금 출력을 낼 때 미래 입력을 안 보는 것이다.
실시간으로 돌리려면 반드시 필요하고, 앞 편들이 이 축으로 모델을 갈라 봤다.
온라인 평가 모드는 다른 축이다.
세션을 처음부터 순서대로 처리하면서 상태를 이어 가는 방식이고, 비인과 모델도 세그먼트 단위로는 온라인으로 굴릴 수 있다.
이 논문은 뒤쪽이다.
백본은 세그먼트 안에서 미래를 보는 비인과 모델이고, 세그먼트끼리는 순서대로 처리하며 뱅크를 이어 간다.
그래서 이 논문의 순차 처리는 앞을 내다보는 지연을 만들지 않는다.
세그먼트 하나를 처리하는 데 필요한 것은 그 세그먼트와 지금까지의 뱅크뿐이고 다음 세그먼트를 기다리지 않는다.
다만 논문의 결론이 다른 축의 지연을 든다.
조회와 뱅크 갱신이 연산을 더해 추론 지연을 늘린다는 것이고, 이 논문이 스스로 적은 유일한 한계다.
다만 4.2에서 본 대로 학습에서는 순서가 없다.
무작위로 뽑은 묶음으로 학습하고 평가에서는 순서대로 도는 셈이라, 학습과 추론이 이 축에서 완전히 같지는 않다.
6.3 WSJ만 학습한 쪽이 더 나은 자리
표 1을 세로로 읽으면 예상과 어긋나는 자리가 나온다.
Libri2mix 열에서 WSJ만 학습한 모델이 WSJ와 ESD를 함께 학습한 모델보다 낫다.
EvoTSE 기준으로 17.91 dB 대 17.27 dB다. 기준선도 같은 방향이라 16.65 대 16.28이다.
논문은 이유를 적는다.
ESD가 주는 감정 다양성이 강건함에는 도움이 되지만 음향 변동을 더해서,
감정이 없는 환경에서의 정밀도를 떨어뜨린다는 설명이다.
이 설명은 그럴듯하지만 표로 확인되지는 않는다.
학습 데이터를 늘렸을 때 도메인 밖 성능이 떨어지는 것은 여러 원인이 가능하고, 논문은 그중 하나를 골라 적었다.
그리고 5.9에서 본 조건이 여기 걸린다.
WSJ+ESD 설정은 체크포인트를 평가 목록으로 고르므로 두 설정의 모델 선택 조건이 같지 않다.
이 비교를 학습 데이터만의 차이로 읽기 어려운 자리다.
6.4 SI-SDRiC은 거의 안 움직인다
표 1의 셋째 지표를 세로로 훑으면 다른 둘과 성질이 다르다.
WSJ으로 학습해 ESD로 평가한 네 행이 13.28과 13.37과 13.45와 13.59다.
SI-SDRi가 1.81에서 11.34까지 여섯 배 넘게 움직이는 동안 이 값은 0.31밖에 안 움직인다.
WSJ+ESD 쪽도 17.79에서 17.90 사이에 모여 있다.
논문도 이 사실을 짚는다. 어느 방법이든 목표 화자를 제대로 잡기만 하면 백본이 비슷하게 뽑아낸다는 뜻이라 적는다.
이것이 백본을 안 고쳤다는 가장 직접적인 증거다.
분리 능력이 달라졌다면 제대로 잡은 세그먼트에서의 품질도 달라져야 하는데 그렇지 않다.
같은 사실이 이 지표의 한계이기도 하다.
5.6에서 본 대로 모집단이 방법마다 다르므로, 값이 비슷하다는 것이 반드시 같은 능력을 뜻하지는 않는다.
다만 크게 안 움직인다는 관찰은 그대로 유효하다.
6.5 그래서 이 논문이 고친 것은 무엇인가
앞 절들을 모으면 배제가 하나 성립한다. SI-SDRiC이 안 움직이므로 이 논문이 백본의 분리 능력을 올린 것이 아니다.
도메인 안에서의 이득도 작다.
WSJ으로 학습해 WSJ으로 평가하면 Standard가 23.35 dB이고 EvoTSE가 23.40 dB로 0.05 dB 차이다.
그런데 Static은 23.01 dB다. 묶음을 만들고 등록 음성을 고정하는 것만으로 Standard보다 0.34 dB 잃는다.
세그먼트마다 새로 고르던 것을 하나로 묶었으니 나쁜 등록 음성에 걸리면 그 묶음 전체가 그것을 쓴다.
그러면 EvoTSE가 Static보다 얻는 0.39 dB의 대부분이 그 손실을 되찾는 몫이다.
도메인 안에서 이 얼개가 새로 만들어 내는 것은 거의 없다.
이 논문이 고친 것은 누구를 뽑을지 정하는 쪽이고, 그것이 값으로 드러나는 곳은 등록 음성이 어긋나기 쉬운 조건이다.
NSR이 23.9%에서 8.1%로 떨어지는 자리가 그곳이고 조건이 온순하면 고칠 것도 별로 없다.
6.6 표 2는 시작 감정을 바꿔 본다
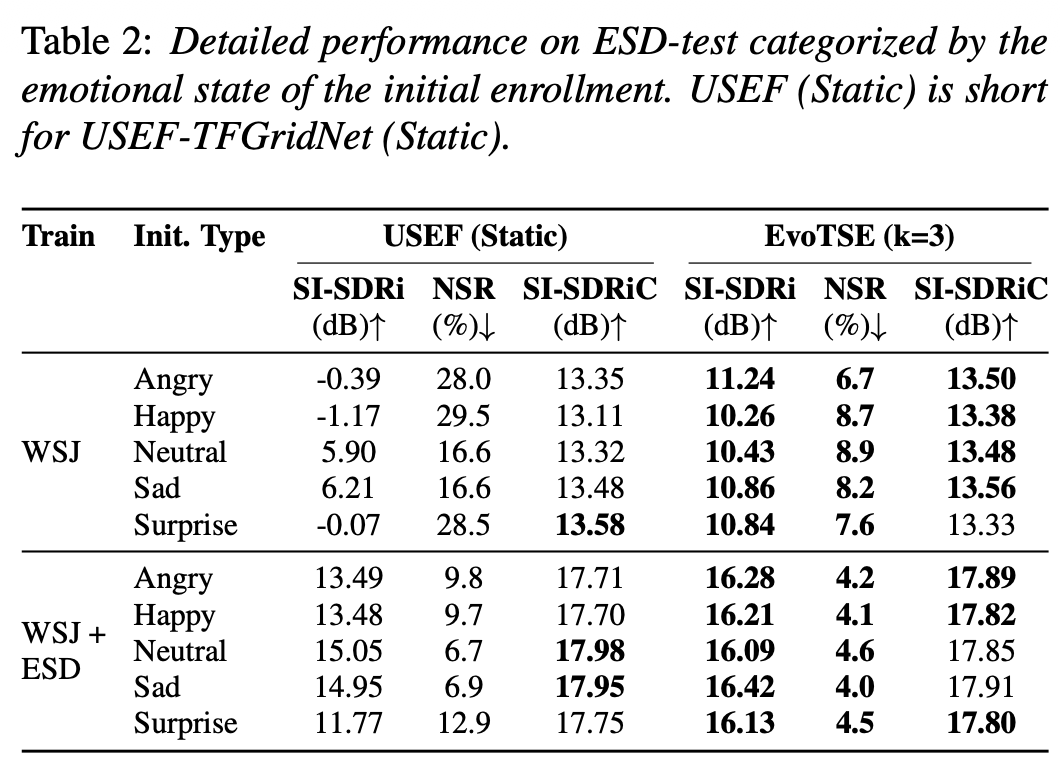
표 1은 시작 등록 음성을 무작위로 골랐다. 표 2는 그것을 감정별로 고정해 놓고 다시 잰다.
기준선의 값이 크게 흔들린다.
WSJ으로 학습한 정적 방식이 화남에서 −0.39 dB, 기쁨에서 −1.17 dB, 놀람에서 −0.07 dB인데 중립에서 5.90 dB,
슬픔에서 6.21 dB다.
음수라는 것은 추출한 신호가 혼합보다 나쁘다는 뜻이다.
감정이 강한 등록 음성으로 시작하면 평균적으로 손해를 본다는 것이고,
NSR도 화남 28.0%와 기쁨 29.5%로 중립 16.6%의 거의 두 배다.
이 표가 1.4의 서술을 값으로 만든다.
등록 음성이 지금의 목표 화자보다 방해 화자에 더 가까워지는 상황이 실제로 있고, 그때 무슨 일이 벌어지는지가 이 행들이다.
WSJ+ESD로 학습하면 폭이 줄지만 없어지지는 않는다. 11.77에서 15.05 사이이고 여전히 3 dB 넘게 벌어진다.
6.7 EvoTSE는 시작 감정에 거의 안 흔들린다
같은 표의 오른쪽이 EvoTSE다. WSJ으로 학습한 값이 10.26에서 11.24 사이에 모여 있다.
기준선의 폭이 7.38 dB인데 이쪽은 0.98 dB다. 시작 감정이 무엇이든 비슷한 자리로 수렴한다는 뜻이다.
이유는 뱅크가 하는 일에 있다.
시작이 치우쳐 있어도 몇 걸음 지나면 그 화자의 다른 상태들이 뱅크에 쌓이고,
그때부터 참조는 시작이 아니라 축적된 것으로 정해진다.
3.3의 다리 놓기가 여기서 값으로 나타난다.
화남으로 시작해도 중간 감정을 거쳐 중립까지 뱅크가 넓어지므로, 어디서 시작했는지가 몇 걸음 뒤에는 거의 지워진다.
WSJ+ESD 쪽도 16.09에서 16.42로 폭이 0.33 dB다. 이 안정성이 이 논문의 주장 가운데 표로 가장 잘 뒷받침되는 부분이다.
6.8 표 3의 Oracle이 천장을 그린다
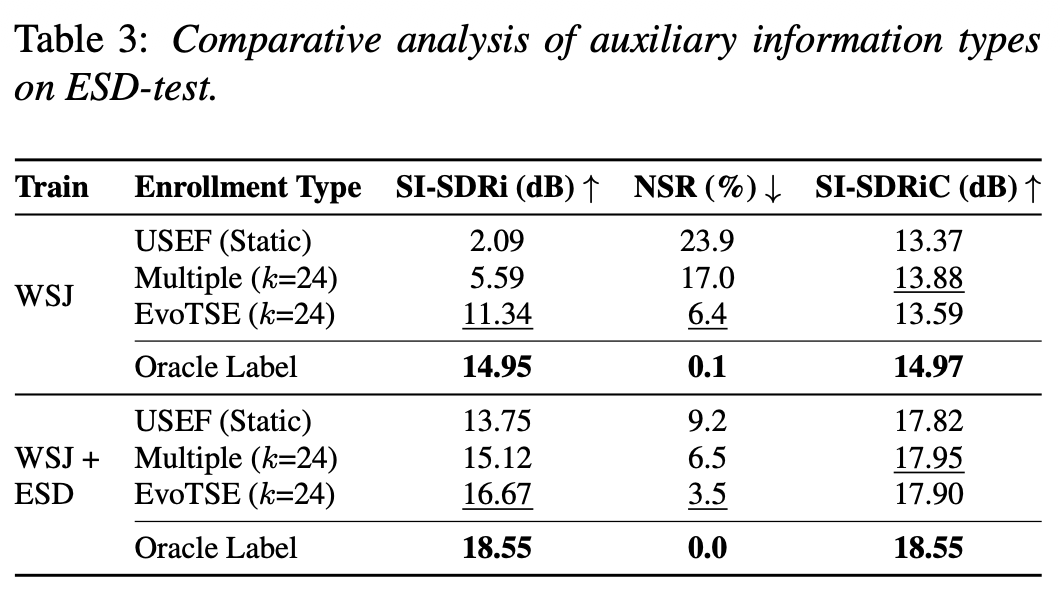
표 3은 등록 음성을 무엇으로 주느냐만 바꿔 넷을 견준다.
정적 하나와 여러 개를 이어 붙인 것 하나와 EvoTSE 하나, 그리고 정답 음성을 등록 음성으로 준 Oracle이다.
Oracle은 실제로 쓸 수 없는 설정이다. 뽑아야 할 목표 신호를 참조로 주는 것이라 시험 삼아 재는 상한이다.
그 값이 WSJ 학습에서 14.95 dB에 NSR 0.1%다. WSJ+ESD에서는 18.55 dB에 0.0%다.
이 값이 알려 주는 것은 등록 음성만 고쳐서 갈 수 있는 거리다.
백본을 그대로 두고 참조만 완벽하게 만들면 거기까지 가고, 그 위로는 백본을 고쳐야 한다.
EvoTSE는 11.34와 16.67이다.
Oracle까지 각각 3.61과 1.88이 남아 있으므로 등록 음성을 고르는 축에서 아직 여지가 있다는 읽기가 가능하다.
6.9 세그먼트를 늘리기만 해도 좋아진다
표 3의 둘째 행이 Multi-Enroll이다. 그 화자의 발화 스물넷을 무작위로 골라 시간축으로 이어 붙여 등록 음성으로 쓴다.
조회도 없고 게이트도 없다. 그냥 참조를 길게 만들고 여러 상태를 섞어 넣은 것이다.
그것만으로 NSR이 23.9%에서 17.0%로 떨어진다. SI-SDRi도 2.09에서 5.59 dB로 오른다.
이 행이 중요한 이유는 EvoTSE의 이득을 갈라 보게 해 주기 때문이다.
참조를 여러 개로 만드는 것만으로 얻는 몫이 여기까지이고, 그 위가 조회와 게이트의 몫이다.
EvoTSE는 6.4%까지 내린다.
그리고 Multi-Enroll이 깨끗한 발화 스물넷을 미리 갖고 있어야 하는 데 비해 EvoTSE는 무작위 등록 음성 하나로 시작하므로,
조건이 더 나쁜 쪽이 더 좋은 결과를 낸다.
6.10 그런데 SI-SDRiC은 Multiple이 이긴다
같은 표의 셋째 지표에서 순서가 뒤집힌다. WSJ 학습에서 Multi-Enroll이 13.88이고 EvoTSE가 13.59다.
WSJ+ESD에서도 같다. 17.95 대 17.90으로 차이는 작지만 방향은 같다.
논문 본문은 EvoTSE가 Multi-Enroll보다 훨씬 낫다고 적는다. 그 문장은 SI-SDRi와 NSR에서는 맞고 이 열에서는 맞지 않는다.
다만 이것을 성능이 낮다고 읽으면 안 된다. 5.6.1에서 본 대로 이 값은 조건부 평균이고 모집단이 방법마다 다르다.
EvoTSE는 혼동을 6.4%까지 줄였으므로 Multi-Enroll이 포기한 어려운 세그먼트가 평균에 더 많이 들어와 있다.
그래서 이 자리는 결함이 아니라 서술의 문제다.
표에 세 지표를 나란히 싣고 그중 둘만 성립하는 문장을 쓰면, 읽는 사람은 세 지표 모두에서 이겼다고 읽는다.
표를 옮길 때는 어느 열에서 어떤 주장이 성립하는지를 함께 옮겨야 한다.
6.11 τ 스윕이 그리는 곡선
그림 3이 임계값을 0.0부터 1.0까지 훑는다. 이 편이 이 논문을 읽는 이유가 그 곡선이다.
왼쪽 끝이 게이트를 끈 상태다. 모든 추출 결과가 뱅크에 들어가고 WSJ 학습 모델의 SI-SDRi가 1.03 dB로 떨어진다.
정적 기준선 2.09 dB보다 1.06 dB 낮으므로 갱신을 아예 안 하느니만 못하다.
WSJ+ESD 쪽에서는 NSR이 9.2%에서 14.3%로 오른다. 두 설정 모두에서 게이트 없는 갱신이 기준선보다 나쁘다.
오른쪽 끝은 아무것도 통과하지 못하는 상태다.
뱅크가 비어 있으니 참조는 초기 등록 하나뿐이고 정적 방식과 같은 동작이 된다.
논문도 그 끝점이 기준선과 정확히 같다고 적는다.
가장 좋은 값이 0.5다. 그 자리에서 SI-SDRi가 10.73 dB이고 왼쪽 끝의 1.03과 견주면 임계값 하나가 9.70 dB를 가른다.
조회도 축출도 그대로 두고 조건 한 줄만 바꾼 결과다.
6.12 k 스윕은 1에서 이미 이긴다
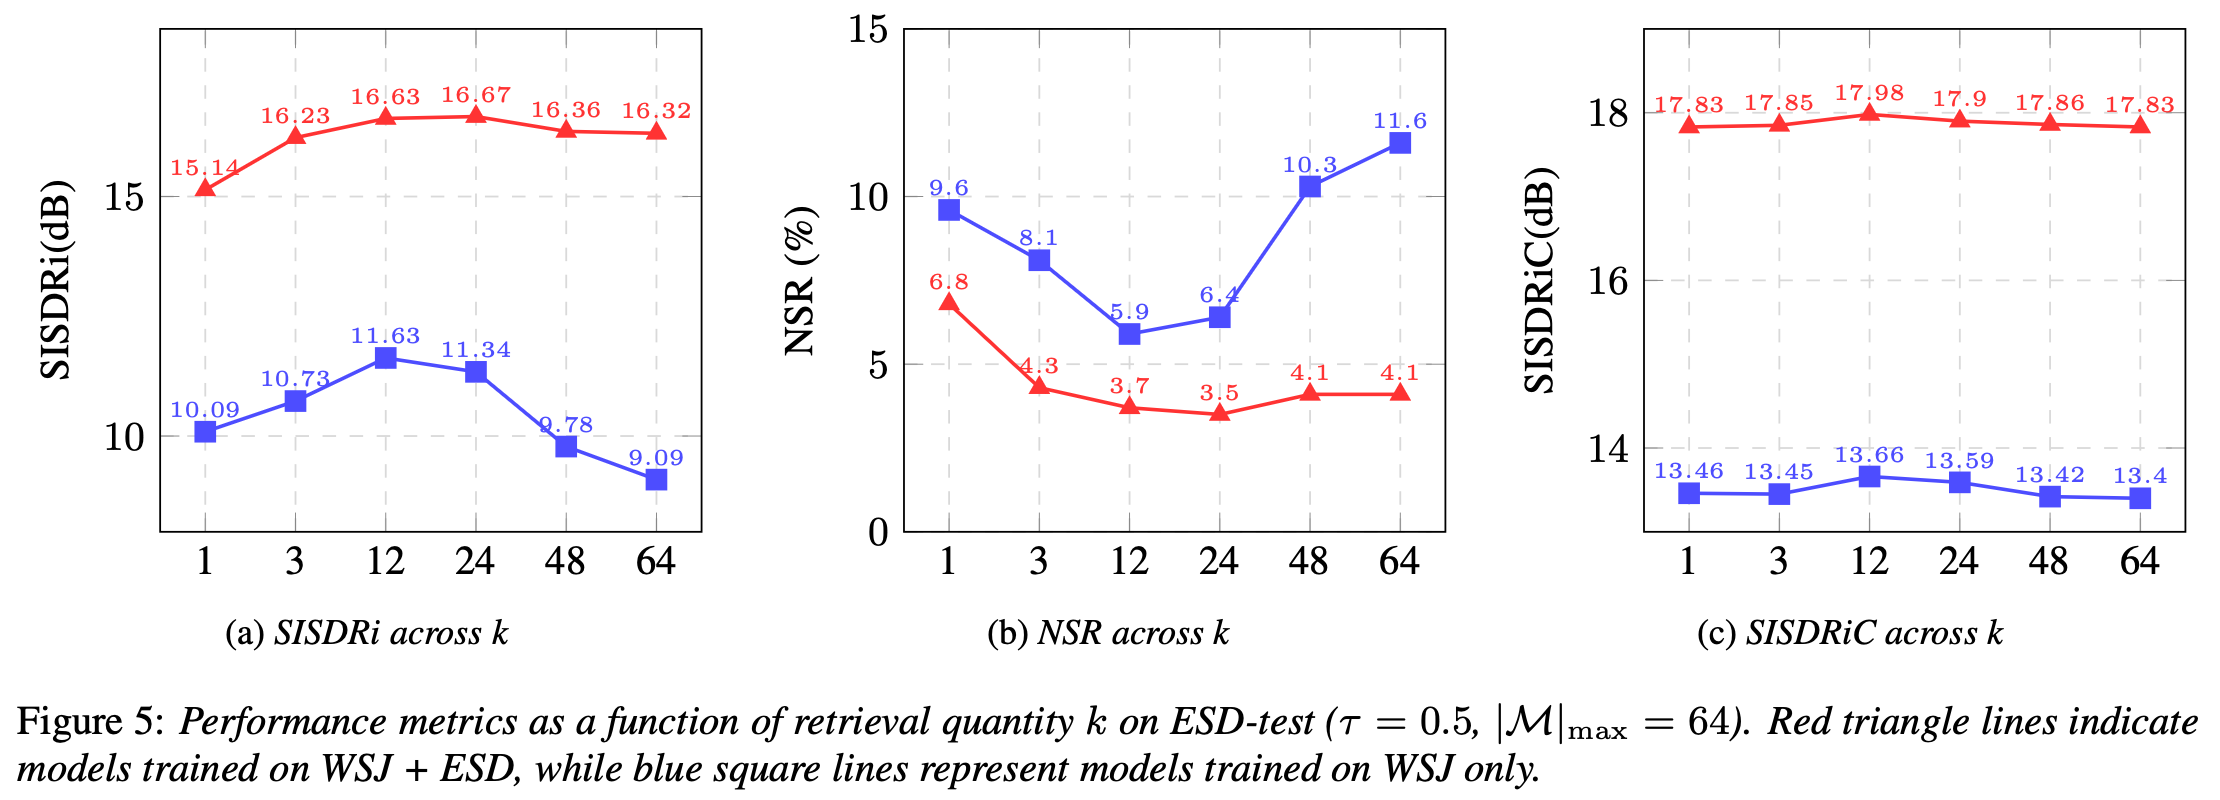
그림 5는 조회 개수를 바꿔 가며 잰다. 곡선이 왼쪽 끝에서 이미 높다.
k가 1일 때 WSJ 학습 모델의 SI-SDRi가 10.09 dB다. 정적 기준선이 2.09 dB이므로 8 dB를 얻는다.
2.5에서 본 대로 여기서도 실제 조회는 하나가 아니라 하나에서 둘이다.
그 뒤로는 완만하게 오르다가 열둘에서 가장 높고 스물넷부터 내려간다.
마흔여덟에서 더 내려가고 예순넷에 이르면 논문이 뚜렷한 하락이라 적는다.
WSJ 모델에서 11.63 dB가 9.09 dB까지 내려가므로 k가 1일 때의 10.09보다도 낮다.
이 모양은 이 얼개의 성격을 말해 준다.
참조를 여러 개 붙이는 것 자체보다 지금 상태에 맞는 것을 하나라도 붙이는 것이 결정적이다.
다만 이 곡선의 오른쪽 절반은 배포된 설정으로 재현되지 않는다.
7.6에서 보겠지만 슬롯이 열여섯이라 후보가 열일곱뿐이고, 조회 개수를 열일곱 이상으로 올리면 언제나 후보 전체가 뽑힌다.
스물넷과 마흔여덟과 예순넷이 같은 집합을 주는 셈이다.
6.13 순차 학습을 빼면 기준선보다 나쁘다
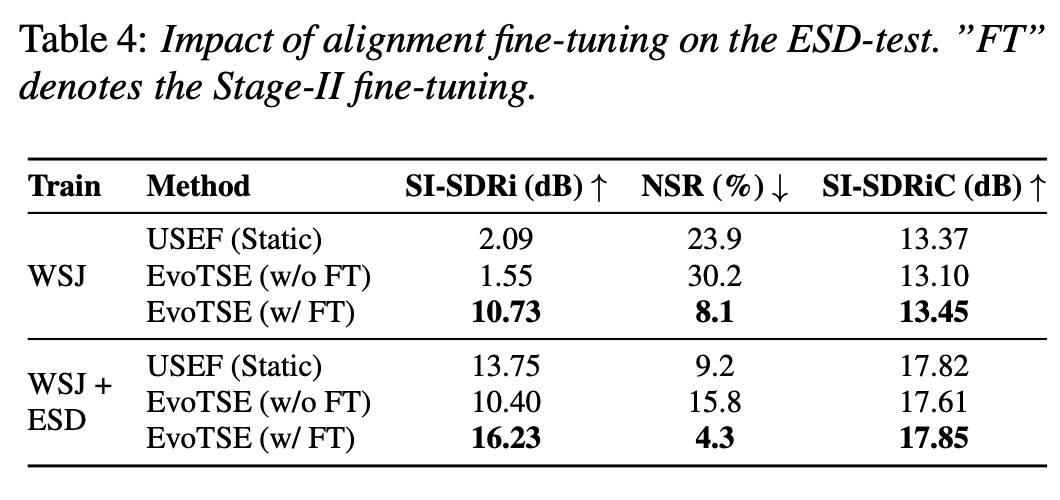
표 4가 2단계 학습만 빼고 나머지를 그대로 둔 결과를 낸다.
조회도 게이트도 축출도 그대로이고 학습만 1단계에서 멈춘 모델이다.
WSJ 학습에서 SI-SDRi가 1.55 dB이고 NSR이 30.2%다. 정적 기준선이 2.09 dB에 23.9%이므로 두 지표 모두 기준선보다 나쁘다.
WSJ+ESD에서도 같다. 10.40 dB에 15.8%로, 기준선 13.75 dB와 9.2%에서 크게 물러난다.
이 행이 3.4의 주장에 짝을 붙인다. 임계값 하나가 9.70 dB를 가르는 것은 맞지만 그 게이트는 순차 학습 위에서만 작동한다.
참조를 갈아 끼우는 기제와 그 참조를 쓸 줄 아는 모델이 둘 다 있어야 하고, 하나만으로는 기준선 아래로 간다.
논문이 이 표를 절제 실험으로만 다루는 것이 조금 아쉬운 자리다.
이 결과는 곁가지가 아니라 이 얼개가 왜 두 부분으로 되어 있는지를 설명하는 자리이고,
4.1이 수렴 속도로 든 이유보다 훨씬 강한 근거다.
7. 저자 코드로 직접 세어 본다
7.1 무엇을 세고 무엇을 못 세나
저자 공개 구현은 있고 배포 체크포인트와 학습 로그는 없다.
그래서 층을 옮겨 세어 저자가 찍은 총계와 맞추는 방식은 못 쓴다.
설정 파일과 소스를 읽어 식을 세우고, 세운 모델을 실제로 만들어 세는 쪽으로 간다.
환경은 이렇게 만든다.
conda create -y -n paper-verify python=3.12 matplotlib numpy
conda run -n paper-verify pip install torch
공통 설정은 원문 두 벌을 읽고 설정 파일 넷을 문자 그대로 파싱한다.
설정 파일에 speechbrain 태그가 섞여 있어 평문 파서로는 못 읽고,
파서를 통과시키면 그 파서가 값을 해석해 버리므로 파일이 적은 글자를 그대로 본다.
def cfg(name, key, cast=str):
    """config 한 줄에서 값을 뽑는다. **키가 두 번 나오면 멈춘다.**"""
    hits = re.findall(rf"^\s*{re.escape(key)}\s*:\s*(\S+)", CFG_TXT[name], re.M)
    assert len(hits) == 1, (name, key, hits)
    return cast(hits[0])


def both(s):
    """같은 문자열이 **두 판본 모두**에 있는지 본다. 한쪽 추출 사고를 잡는다."""
    a = TXT.count(s)
    b = SQ.count(re.sub(r"\s+", "", s))
    assert a >= 1 and b >= 1, (s[:60], a, b)
    return s
못 세는 것이 둘이다. 하나는 데이터다.
WSJ0-2mix와 ESD와 Libri2Mix의 혼합이 없으므로 표 1부터 표 4까지의 dB와 NSR과 SI-SDRiC은 전부 재현 불가다.
다른 하나는 저자의 평가 경로 자체인데, 지표를 만드는 스크립트가 정의되지 않은 이름을 부르기 때문이다.
compute_sisdr.py           미정의 이름 3개
                            _compute_sisnr_single · compute_sisdr · compute_sisnr_dir
                            그중 직접 호출 ['compute_sisdr', 'compute_sisnr_dir']
                            참조로만 넘긴 것 ['_compute_sisnr_single']
compute_sisdr_wsj.py       미정의 이름 2개
                            compute_sisdr · compute_sisnr_dir
                            그중 직접 호출 ['compute_sisdr', 'compute_sisnr_dir']
                            참조로만 넘긴 것 []
7.2 STFT 규격을 8 kHz로 환산한다
논문 5.3절이 창 길이 16 밀리초와 홉 길이 8 밀리초, 65차원 복소 특징이라 적는다.
표본화율 8 kHz를 곱하면 표본 수가 나오고, 실수 신호의 rFFT 빈 개수는 창 길이의 절반에 하나를 더한 값이다.
SR = cfg("EvoTSE-wsj", "sample_rate", int)
win = SR * WIN_MS // 1000          # 16 ms -> 표본
hop = SR * HOP_MS // 1000          # 8 ms  -> 표본
bins = win // 2 + 1                # 실수 신호의 rFFT 빈 개수
무엇 논문 환산 config 판정
창 길이 16 ms 128 128 일치
홉 길이 8 ms 64 64 일치
n_fft 16 ms 128 128 일치
복소 특징 차원 65 65 65 일치설정 파일 넷이 모두 같은 값을 쓴다. 하나만 보고 일반화하지 않으려고 넷을 다 확인했고 전부 일치한다.
나머지 세 값 가운데 둘은 맞고 하나는 이름이 어긋난다.
2차원 합성곱의 출력 채널 128과 어텐션 헤드 넷은 설정 파일과 같은데,
논문이 512차원 FFN이라 부른 값은 설정 파일에서 어텐션의 질의·키 폭이고 실제 FFN 폭에 해당하는 항목은 256이다.
값 512는 실재하지만 그것이 가리키는 자리가 다르다.
7.3 백본을 세워서 파라미터를 센다
논문은 파라미터 총계를 어디에도 적지 않는다.
그래서 맞출 바깥 값이 없고 대신 부품으로 갈라 층 정의에서 다시 유도한 값과 대조한다.
합계만 보면 서로 상쇄하는 오차가 통과하기 때문이다.
model = Tar_Model(stft=STFT(n_fft=NFFT, hop_length=HOP, win_length=NFFT),
                  istft=iSTFT(n_fft=NFFT, hop_length=HOP, win_length=NFFT),
                  real_att=TF_gridnet_attentionblock(emb_dim=EMB, n_freqs=NF,
                                                     n_head=NH, approx_qk_dim=QK),
                  n_freqs=NF, hidden_channels=HID, n_head=NH, emb_dim=EMB,
                  emb_ks=KS, emb_hs=HS, num_layers=NL)
TOTAL = sum(p.numel() for p in model.parameters())
부품 파라미터 비중
dual_mdl 15,551,694 99.4%
att 82,893 0.5%
deconv 4,610 0.0%
conv 2,688 0.0%
합계 15,641,885 100.0%
블록 6개 · 블록당 2,591,949개 · 전부 같은가: True
2,591,949 x 6 = 15,551,694 (dual_mdl과 일치)인코더와 디코더는 층 정의에서 다시 유도해 맞춘다.
커널 크기와 입력 채널을 하드코딩하지 않고 소스에서 읽는데,
하드코딩하면 그 값을 거는 단언이 항등식이 되어 원리적으로 못 터지기 때문이다.
유도한 값이 센 값과 정확히 같다.
한 가지 밝혀 둘 것이 있다. 설정 파일의 질의·키 폭만 분리기 블록에 닿지 않는다.
저자 소스가 그 자리에 512를 리터럴로 박아 두었고, 나머지 여섯 값은 인자로 들어가므로 분리기도 설정 파일을 본다.
지금은 두 값이 같아 관측이 갈리지 않지만,
그 항목 하나를 바꾸면 세운 모델과 실제 모델이 달라지면서도 단언은 전부 통과한다.
7.4 컴포넌트 연결이 두 방식으로 끊겨 있다
설정 파일이 세 컴포넌트의 클래스 경로를 문자열로 적고, 모델 클래스가 넷째 하나를 기본 인자로 들고 있다.
그 넷을 그대로 import 해 본다.
for key, path in DECL.items():
    mod = path.rsplit(".", 1)[0]
    try:
        importlib.import_module(mod)
        res = "OK"
    except Exception as e:
        res = type(e).__name__
무엇 적힌 경로 결과
classifier_cls models.local.classifier_api.ThresholdClassifier ModuleNotFoundError
aux_builder_cls models.local.aux_builder.SampleSegmentAuxBuilder ModuleNotFoundError
aux_selector_cls models.local.aux_selector.TopKSelector ModuleNotFoundError
aux_replacer_cls models.local.aux_replacer.DefaultReplacer ModuleNotFoundError넷 다 없는 모듈이다. 실제 파일은 'models/evo_comp/'에 있고 'models/' 아래에 초기화 파일이 하나도 없어 재수출도 없다.
저자가 파일을 옮기고 경로 문자열을 안 고친 모양이다.
넷째 하나는 설정 파일에 없다.
모델 클래스의 기본 인자에 박혀 있어 설정으로 고칠 수 없고, 그 자리를 고치려면 소스를 고쳐야 한다.
경로를 바로잡아도 하나는 여전히 죽는다.
신뢰도 분류기 파일이 첫머리에서 없는 모듈을 import 하는데, 그 이름은 그 파일 어디에서도 쓰이지 않는다.
죽은 import 하나가 모듈 전체를 막는다.
7.5 조회 집합 크기를 세어 본다
식 (5)가 두 집합의 합집합이라 실제 조회 개수는 k와 2k 사이다. 선택기를 직접 세워 돌려 본다.
def retrieved(n_bank, k, seed=0):
    """뱅크에 n_bank개가 있을 때 TopKSelector가 실제로 몇 개를 주는지 센다."""
    rnd = random.Random(seed)
    keys = [f"est_{i:04d}" for i in range(n_bank)]
    emo = {x: rnd.random() for x in keys}
    spk = {x: rnd.random() for x in keys}
    return TopKSelector(top_k=k)({"aux_keys": keys, "emo_sim_vec": emo, "spk_sim_vec": spk})
뱅크 k 실제 하한 k 상한 2k 판정
64 3 6 3 6 범위 안
64 24 39 24 48 범위 안
16 3 6 3 6 범위 안
16 24 16 16 16 범위 안논문의 서술과 맞는다. 두 스트림이 겹치지 않으면 2k에 닿고 겹칠수록 k에 가까워지며, 뱅크가 작으면 그 크기에서 잘린다.
표를 읽을 때 이 사실을 알고 봐야 한다.
표 1의 'k=3'은 세 개가 아니라 세 개에서 여섯 개이고, 표 3의 'k=24'는 스물넷에서 마흔여덟이다.
7.6 슬롯 열여섯과 k=24를 함께 놓는다
선택기가 보는 후보는 슬롯 수보다 하나 많다.
저자 코드가 초기 등록을 뱅크 항목들과 같은 자리에 넣고, 정원을 셀 때만 그것을 뺀다.
only(CHAIN, r"^\s*(self\.aux_buffer_list\['est_aux'\]\['init'\] = self\.aux_buffer_list\['init_aux'\])\s*$")
only(REP, r"^\s*(existing_keys = \[k for k in aux_buffer_list\['est_aux'\]\.keys\(\) if k != 'init'\])\s*$")
N_CAND = cap + 1
k 조회 개수 후보 전체와 같은 집합인가
3 5 다르다
8 12 다르다
12 14 다르다
16 17 같다
17 17 같다
24 17 같다
48 17 같다
64 17 같다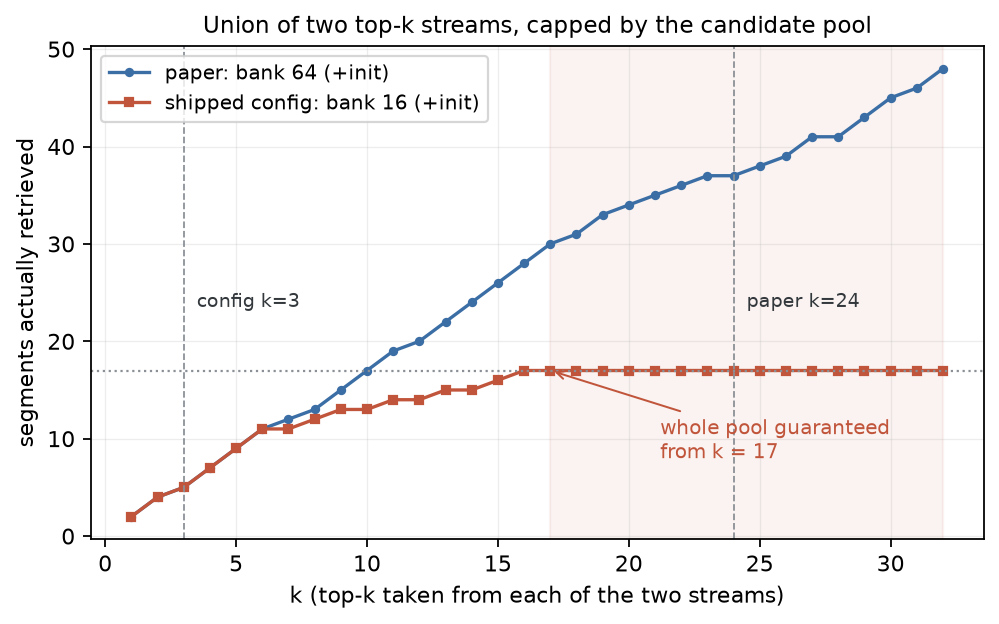
그림 6이 k를 1에서 32까지 훑은 것이고, 두 곡선 모두 후보 수에서 평평해진다. 구조적으로 보장되는 것은 하나다.
스트림 하나가 후보 전체를 주려면 k가 후보 수 이상이면 되므로, 열일곱 이상에서는 언제나 전체가 뽑힌다.
그보다 아래에서 어디서 포화하는지는 두 순위표가 얼마나 겹치느냐에 달렸고 그 값은 시드마다 달라지므로 값으로 인용하지 않는다.
그래서 이 편이 내는 판정은 이것이다.
논문 6.5절이 훑는 스물넷과 마흔여덟과 예순넷은 배포된 설정에서 전부 같은 집합을 준다.
그 구간에서 성능이 변한다는 서술은 배포된 설정으로 재현되지 않는다.
7.7 등록을 만드는 코드가 식 (6)과 다르다
식 (6)은 초기 등록 뒤에 조회한 세그먼트를 차례로 붙인다고 적는다. 그러면 결과의 길이가 입력 길이의 합이어야 한다.
그런데 등록을 실제로 만드는 자리는 'src/models/evo_comp/aux_builder.py'의 세 줄이고 아래는 우리가 옮겨 쓴 것이 아니라 그 파일에서 그대로 뽑은 것이다.
num_select = max(1, int(len(all_segments) * self.clip_ratio))
selected_indices = random.sample(range(len(all_segments)), num_select)
selected_segments = [all_segments[i] for i in sorted(selected_indices)]
config clip_ratio 길이 비율 Concat과 같은가
EvoTSE-wsj 0.5 16,000 0.500 다르다
EvoTSE-wsj+esd 1.0 32,000 1.000 같다코드는 조회한 파형을 62.5 밀리초 조각으로 자르고 한 통에 모은 뒤 비율만큼 무작위로 골라 인덱스 순으로 잇는다.
조각이 예순넷 생기고 비율이 절반이면 서른둘을 고르므로 길이가 정확히 절반이 된다.
중요한 것은 그 비율이 설정마다 다르다는 점이다.
WSJ 설정은 0.5라 식 (6)과 갈리고 WSJ+ESD 설정은 1.0이라 전부 고르므로 결과가 이어 붙인 것과 비트까지 같다.
그래서 이 괴리는 설정 한정으로 적어야 한다. 갈리는지를 정하는 것은 평가 집합이 아니라 학습 설정이다.
WSJ+ESD로 학습한 행들은 식 (6)과 갈리지 않고, WSJ만으로 학습한 행들은 아홉 열 전부가 갈린다.
표 1의 위 네 행과 표 3·표 4의 WSJ 블록이 그쪽이다.
7.8 축출 규칙을 식 (10)과 나란히 놓는다
식 (10)과 축출 코드를 한 줄씩 맞대면 네 자리가 갈린다.
정규화 분모   1 / (|M|max - 1)
                코드: np.mean(...). 실제 항 수로 나눈다 (두 점수 경로 모두)
모집단        j != i, 뱅크 안끼리
                코드: for other in ['init'] + existing_keys
가중치        화자항 1, 감정항 alpha
                코드: buffer_select_weights = {'spk': 0.5, 'emo': 0.5}
판정          최대 Omega를 빼고 새것을 넣는다
                코드: should_replace = new_score < candidate_score
앞의 셋은 순위를 크게 흔들지 않는다.
뱅크가 꽉 차 있으면 나누는 수가 같고, 가중치는 둘 다 0.5라 alpha가 1일 때와 순위가 같으며,
초기 등록이 모집단에 드는 것은 항목 하나가 늘어나는 정도다.
넷째가 다르다.
그 조건이 거짓이면 코드는 새 추정치를 버리고, 게이트를 통과해 신원이 확인된 세그먼트가 뱅크에 못 들어간다.
논문에는 그 경로가 없다.
얼마나 자주 밟히는지를 세려면 유사도 행렬을 실제 추론처럼 채워야 한다.
비워 두면 후보 점수가 전부 0이 되어 판정이 무너지고, 그 상태로 재면 거의 동전 던지기가 나온다.
유사도 행렬          시드     폐기     교체               비고
비운 채(퇴화)         60      27      33  후보 점수가 전부 0이라 판정이 무너진다
채운 채(추론과 같음)   60       3       57        이쪽이 실제 동작이다
실제 동작에서 폐기는 예순 번 중 세 번이다.
드물지만 존재하고 5.7에서 본 세션 길이를 생각하면 한 세션에서 여러 번 일어난다.
7.8.1 식이 정하는 것과 코드가 정하는 것
논문과 구현이 갈릴 때 어느 쪽을 기준으로 읽어야 하는지는 무엇을 하려는지에 달렸다.
표의 숫자를 이해하려는 것이라면 코드가 기준이다. 그 숫자를 만든 것이 코드이고 식은 그 코드를 요약한 서술이기 때문이다.
이 얼개를 다시 만들려는 것이라면 식이 출발점이다. 다만 식만 보고 만들면 이 편이 짚은 자리에서 다른 것을 얻는다.
참조의 길이가 다르고, 뱅크 용량이 다르고, 게이트를 통과한 세그먼트가 버려지는 경로가 없다.
앞 편들에서도 같은 상황을 여러 번 봤다.
Multi-View 편은 논문이 말한 대칭성을 구현이 강제하지 않았고,
MoMuSE 편은 식과 구현이 사영 공유와 편향과 온도 세 자리에서 갈렸다.
되풀이되는 모양이라 규칙으로 적어 둘 만하다.
식을 옮겨 쓸 때는 그 식이 나온 코드를 함께 열고, 갈리는 자리를 목록으로 만들어 두는 것이 안전하다.
7.9 τ는 배포 코드로 바꿀 수 없다
논문 6.4절이 임계값을 0.0부터 1.0까지 훑는다. 그 실험을 다시 하려면 값을 바꿀 수 있어야 한다.
추론 스크립트에 그 이름의 인자가 있다.
기본값이 0.5이고 저장소 README가 그것을 뱅크 갱신용 화자 유사도 임계값이라 설명한다.
셸 스크립트는 그 값을 제대로 넘긴다. 출력 디렉터리 이름에 쓰고 추론 스크립트에도 인자로 전달한다. 문제는 받는 쪽이다.
파이썬 안에서 그 이름은 선언 한 곳에만 나타나고 읽는 곳이 없으며,
모델 클래스의 세터는 본문이 비어 있고 부르는 곳도 없다.
inference.py의 spk_sim_throld 등장 1회 (선언 1회)
세터        : def set_sim_throld(self, sim_throld): pass
세터 호출부 : 0곳
config의 유효값 decision_threshold : [0.75, 0.75]
논문 6.4가 최적이라 한 값                   : 0.5
실제로 도는 값은 설정 파일의 0.75 하나다.
논문이 최적이라 한 0.5와 다르고 게다가 그 값을 받는 분류기 모듈은 7.4에서 본 대로 import 자체가 안 된다.
그래서 이 편이 읽으려고 온 절제 실험은 배포된 코드로 재현되지 않는다.
곡선이 옳은지 그른지가 아니라, 그것을 다시 그릴 방법이 저장소에 없다는 뜻이다.
7.10 초록이 약속한 체크포인트를 찾는다
초록의 마지막 문장이 코드와 체크포인트를 공개한다고 적는다. 코드는 있다.
체크포인트를 확장자 여덟 가지로 전수 검색했다.
저장소 파일 188개(디렉터리 48개는 뺐다)
  *.pt             0건
  *.pth            0건
  *.pth.tar        0건
  *.ckpt           0건
  *.bin            0건
  *.safetensors    0건
  *.onnx           0건
  *.tar            0건
전부 0건이다.
README에 링크가 둘 있는데 하나는 데모 페이지이고 하나는 화자 인코더 도구의 저장소라 이 논문의 가중치가 아니다.
설정 파일이 가리키는 경로는 있다.
1단계 체크포인트를 특정 경로에서 읽는다고 적혀 있지만 그 파일이 저장소에 없고,
추론 스크립트가 받는 체크포인트 이름도 사용자가 직접 만든 것을 전제한다.
가중치가 없으므로 이 글은 표의 dB와 NSR을 하나도 재현하지 못한다.
판정표의 마지막 행이 재현 불가인 것은 그 때문이고, 표 안의 값끼리 대조하는 것은 그것과 별개로 성립한다.
7.11 표 3의 SI-SDRiC을 표 안에서 대조한다
표 3은 네 설정을 세 지표로 재고, 본문은 EvoTSE가 Multi-Enroll보다 훨씬 낫다고 적는다.
그 문장이 세 지표 모두에서 성립하는지 표 안에서 확인한다.
학습      지표          Multiple    EvoTSE  이긴 쪽
WSJ       SI-SDRi         5.59     11.34  EvoTSE
WSJ       NSR            17.00      6.40  EvoTSE
WSJ       SI-SDRiC       13.88     13.59  Multiple
WSJ+ESD   SI-SDRi        15.12     16.67  EvoTSE
WSJ+ESD   NSR             6.50      3.50  EvoTSE
WSJ+ESD   SI-SDRiC       17.95     17.90  Multiple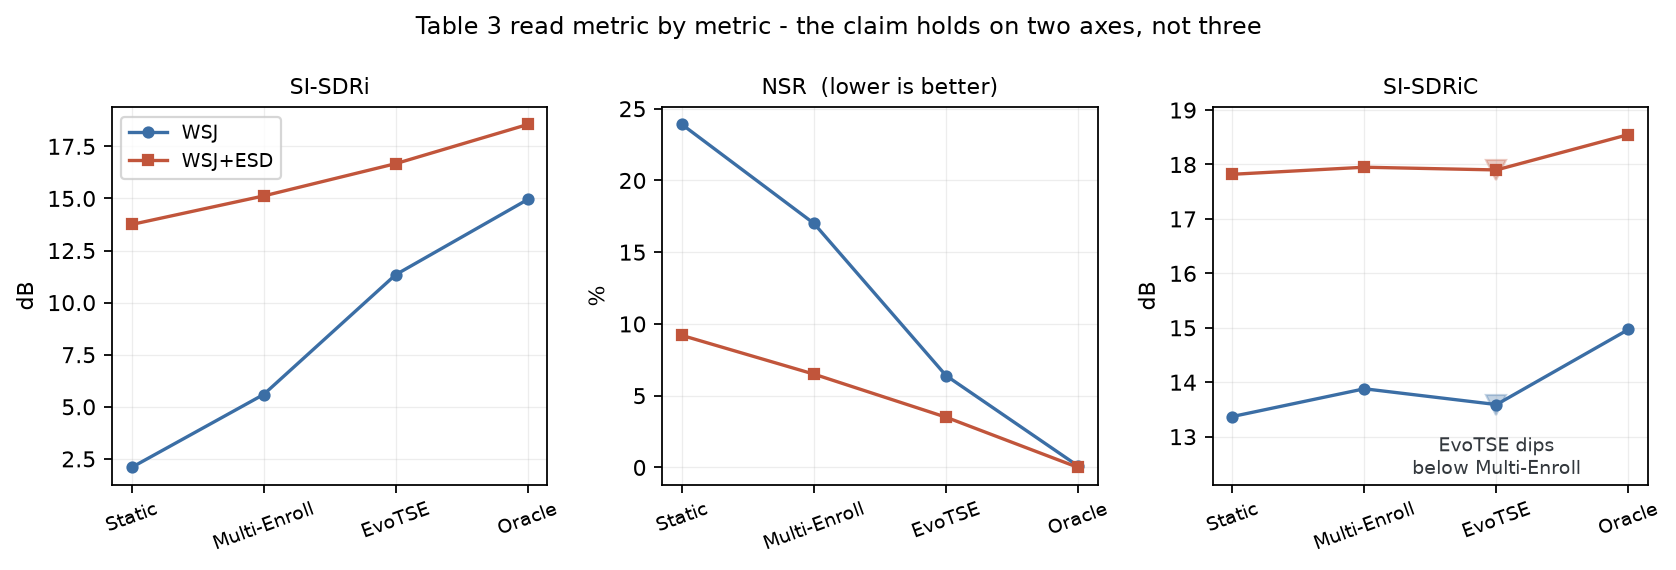
여섯 칸 가운데 둘에서 진다. 그 둘이 모두 SI-SDRiC이고 두 학습 설정 모두에서 그렇다.
그림 7의 세 패널 가운데 오른쪽 하나만 선이 뒤집히는 것이 그 뜻이다.
6.10에서 적은 대로 이것을 성능이 낮다고 읽으면 안 된다.
조건부 평균이라 모집단이 다르고 혼동을 더 많이 줄인 쪽이 어려운 세그먼트를 더 많이 안고 평균을 낸다.
그래도 본문의 문장은 표보다 앞서 나갔다.
세 지표를 나란히 싣고 그중 둘에서만 성립하는 서술을 쓰면, 읽는 사람은 셋 모두를 뜻한다고 읽는다.
7.12 논문 그림 4의 끝점이 표 1과 맞는지 본다
논문 6.4절이 임계값 1.0에서 정적 기준선과 정확히 같아진다고 적는다.
논문 그림 4의 끝점 여섯 값은 원문에 리터럴로 실려 있고, 그 값들이 표 1과 표 3의 정적 행과 같은지를 먼저 확인한다.
학습           지표       표 1 정적    표 3 정적  판정
WSJ       SI-SDRi          2.09       2.09  같다
WSJ       NSR             23.90      23.90  같다
WSJ       SI-SDRiC        13.37      13.37  같다
WSJ+ESD   SI-SDRi         13.75      13.75  같다
WSJ+ESD   NSR              9.20       9.20  같다
WSJ+ESD   SI-SDRiC        17.82      17.82  같다
여섯 값이 전부 맞는다. 두 행은 원문에 실재함을 먼저 확인했으므로 옮겨 적은 값끼리의 대조가 아니다.
이 편의 표제 숫자도 같은 방식으로 센다. 임계값을 끈 자리의 1.03과 최적 자리의 10.73이 원문에 있고 그 차가 9.70이다.
tau          SI-SDRi            무엇인가
0.0             1.03  게이트를 끈다. 정적 기준선보다 낮다
(정적)           2.09  게이트가 없는 기준선
0.5            10.73  논문이 최적이라 한 값

10.73 - 1.03 = 9.70 dB
계보 문서가 이 논문을 등재하며 적은 문장이 그 뺄셈이었다.
계산해 보면 맞고 게이트를 끄면 기준선보다도 1.06 dB 낮다는 사실이 함께 나온다.
7.13 재현되는 것과 안 되는 것
| 논문의 주장 | 판정 |
| STFT 창 길이 16 ms와 홉 길이 8 ms와 65차원 복소 특징 | 재현. 8 kHz에서 128과 64와 65이고 설정 파일 넷이 전부 같다 |
| 512차원 FFN | 부분. 512는 실재하나 어텐션의 질의·키 폭이고 FFN 폭은 256이다 |
| WSJ0-2mix 2만·5천·3천에 평가 화자 열여덟 | 재현. 저장소 목록과 맞고 평가에 쓰는 5,982는 화자마다 등록 하나를 뺀 값이다 |
| ESD 평가 4,986 혼합에 화자 넷 | 재현. 목록을 직접 세어 일치한다 |
| 조회 집합의 크기가 k와 2k 사이 | 재현. 선택기를 돌려 두 스트림 합집합임을 확인했다 |
| 뱅크 용량 예순넷 | 미재현. 배포된 설정 파일 둘 다 열여섯이고 추론에서 덮어쓸 인자가 없다 |
| 식 (6)이 초기 등록 뒤에 조회 결과를 잇는다 | 부분. WSJ+ESD 설정은 비트까지 같고 WSJ 설정은 62.5 ms 조각의 절반만 골라 길이가 반이다 |
| 식 (6)의 초기 등록이 맨 앞에 남는다 | 미재현. 선택기가 고른 목록에 초기 등록을 강제하는 처리가 없다 |
| 식 (8)의 신뢰도가 뱅크 전체와의 최댓값 | 부분. 최댓값 규칙은 같으나 참조 집합이 다르다. 식은 뱅크만이고 코드는 초기 등록을 더해 n=1의 빈 집합을 메운다 |
| 식 (9)의 판정이 임계값 초과 | 부분. 코드는 크거나 같으면 통과라 경계에서 갈린다 |
| 식 (10)의 축출이 최대 중복도를 뺀다 | 부분. 분모와 모집단과 가중치가 갈리고, 논문에 없는 폐기 분기가 있어 예순 번 중 세 번 밟힌다 |
| 임계값 1.0에서 정적 기준선과 같다 | 재현. 여섯 값이 표 1의 정적 행과 전수 일치한다 |
| 임계값 하나가 가르는 폭이 9.70 dB | 재현. 10.73에서 1.03을 빼면 9.70이고 게이트를 끄면 기준선보다 1.06 낮다 |
| 순차 학습을 빼면 기준선 아래로 간다 | 재현. 1.55 대 2.09이고 NSR도 30.2 대 23.9다 |
| EvoTSE가 Multi-Enroll보다 훨씬 낫다 | 부분. SI-SDRi와 NSR에서는 맞고 SI-SDRiC은 두 설정 모두 진다 |
| 조회 개수를 열둘에서 스물넷 사이에서 정점, 마흔여덟과 예순넷에서 하락 | 재현 불가. 배포된 설정에서는 후보가 열일곱이라 그 셋이 같은 집합이다 |
| 임계값 스윕을 저장소 코드로 다시 그릴 수 있다 | 재현 불가. 인자를 읽는 곳이 없고 세터가 무동작이며 분류기 모듈이 import 되지 않는다 |
| 코드와 체크포인트를 공개한다 | 미재현. 코드는 있으나 가중치가 확장자 여덟 가지로 0건이고 배포처도 없다 |
| 표 1~4의 SI-SDRi와 NSR과 SI-SDRiC | 재현 불가. 가중치도 혼합 데이터도 없다 |
표 5. 이 글이 다시 센 것과 못 센 것. 판정 어휘는 재현과 부분과 미재현과 재현 불가 넷이다. 직접 확인한 결과이며 근거는 본문에 적었다.
열아홉 행 가운데 일곱이 재현이고 여섯이 부분이며 셋이 미재현이고 셋이 재현 불가다.
재현 일곱은 대부분 규격과 데이터 목록처럼 설정 파일과 저장소만으로 확인되는 것들이고,
이 편의 표제 숫자인 9.70 dB도 여기에 든다.
부분 여섯 가운데 넷이 논문의 식과 저자 구현이 갈리는 자리다.
식 (6)과 식 (8)과 식 (9)와 식 (10)이고, 그 가운데 축출의 폐기 분기 하나만 논문에 아예 없는 동작이다.
나머지 둘은 성격이 다르다.
512차원은 논문 서술과 설정 파일의 이름이 어긋나는 것이고,
Multi-Enroll 비교는 논문 본문이 자기 표보다 앞서 나간 것이라 표만 봐도 보인다.
미재현 셋은 성격이 다르다.
뱅크 용량과 초기 등록의 위치는 논문의 서술과 배포된 코드가 어긋나는 것이고, 체크포인트는 약속이 지켜지지 않은 것이다.
재현 불가 셋 가운데 하나만 데이터 부재 때문이다.
나머지 둘은 데이터가 있어도 배포된 코드로는 그 실험을 돌릴 수 없다는 뜻이라 성질이 더 나쁘다.
이 편이 읽으려고 온 임계값 스윕이 그중 하나다.
나가며
이 편이 더하는 질문은 이것이다.
자기 출력을 다시 입력으로 쓰는 얼개에서 무엇을 남길지 정하는 규칙은 어디에 적혀야 하는가.
가장 값싼 변경은 조건 한 줄이다. 논문 6.4절이 그것을 보인다.
조회도 축출도 그대로 두고 임계값 하나를 0.0에서 0.5로 올리면 SI-SDRi가 1.03에서 10.73으로 간다.
다만 그 한 줄은 순차 학습 위에서만 작동한다. 6.13에서 본 대로 2단계를 빼면 임계값이 있어도 기준선 아래로 간다.
가장 값어치 있는 결과는 표 2다. 시작 등록 음성의 감정에 따라 기준선이 7.38 dB 흔들리는데 EvoTSE는 0.98 dB 안에 머문다.
이 얼개가 실제로 만든 것은 평균 성능이 아니라 시작 조건에 대한 둔감함이고, 배포에서 값을 만드는 것이 그 성질이다.
남은 문제는 셋이다.
첫째, 논문이 뱅크 용량을 예순넷이라 적는데 배포된 설정은 열여섯이라 조회 개수 실험의 오른쪽 절반이 상수 구간이다.
둘째, 임계값을 바꾸는 경로가 저장소에 없어 논문 6.4절의 스윕을 다시 그릴 수 없다.
셋째, 축출 코드에 논문이 적지 않은 폐기 분기가 있어 게이트를 통과한 세그먼트가 뱅크에 못 들어가는 경우가 있다.
숫자를 옮기기 전에 그 숫자가 어느 표의 어느 설정에서 나왔는지 확인하라는 요구는 앞 편과 같다. 이번에는 하나가 더 붙는다.
식을 옮기기 전에 그 식이 나온 코드를 함께 열어라. 판정표가 부분으로 판정한 식 세 자리는 논문만 읽어서는 보이지 않고,
그중 하나는 논문에 없는 동작이다.
다음은 ISAM이다. 이 편이 뱅크에 무엇을 넣을지 정했다면 그 편은 화면에 함께 있는 다른 얼굴이 없을 때 무엇을 할지 정한다.
계보 문서가 그 편을 단서가 없을 때 백본으로 되돌아가는 훈련법으로 등재해 두었다.
여기서 본 게이트가 오래 닫히는 구간이 그 편이 다루는 자리와 맞닿는다.
참고 자료
본 논문
- Z. Liu, Z. Wang, X. Li, Y. Zhu, S. Wang, L. Xiao, L. Xie, "EvoTSE: Evolving Enrollment for Target Speaker Extraction", Interspeech 2026 투고. arXiv:2604.06810
- 이 글의 수치는 arXiv:2604.06810v2를 기준 판본으로 삼았다. 폴더의 배포 PDF가 v2와 sha256이 같다. v1과 v2는 두 줄만 다른데 익명 저장소 주소가 'github.com/IiuZiKai/Evo_TSE'로 바뀐 것과 arXiv 스탬프뿐이고, 표 값은 한 자리도 갈리지 않는다.
- 저자 저장소가 Interspeech 심사본('docs/Submission_2173_EvoTSE.pdf', 2026-03-05)을 함께 냈다. 공백을 걷어낸 본문 문자 유사도가 0.9940이고 3자 이상 차이 열넷이 전부 익명화와 저장소 주소와 arXiv 스탬프와 그림 눈금이다. 표 값이 갈린 자리는 없다.
- 인용문은 심사본 추출에서 뽑았다. arXiv v2는 GenPDF 재생성본이라 단어 안에 공백이 박힌다('fr om' · 'signifi cant'). 값 대조는 v2로 했다.
- 본문이 여덟 쪽이고 번호 붙은 수식이 열하나, 표가 넷, 그림이 다섯이며 부록은 없다.
- 저자 공개 구현은 있고 배포 체크포인트와 학습 로그는 없다. 그래서 이 글의 검산은 설정 파일과 소스를 읽어 식을 세우는 방식이다.
앞 편들
- Flamingo 편. 동결한 백본에 어댑터를 끼우는 설계. 이 편은 그 어댑터가 들고 있을 뱅크에 무엇을 넣고 무엇을 버릴지를 다룬다. 나가며의 마지막 줄을 이 편 들어가며가 받는다.
- MeMo 편. memory bank와 슬롯, self-enrollment, 그리고 선입선출과 어텐션 기반 축출. 그 편의 뱅크는 담을지 말지를 묻지 않고 무조건 담았고, 이 논문의 게이트는 그 자리에 판정을 하나 넣은 것이다.
- MoMuSE 편. 뱅크가 블록마다 벡터 하나여서 축출 규칙이 없고, 조건이 맞으면 옛 값을 통째로 갈아 끼운다.
- MeMo 편. memory bank를 원어로 확정한 편이고 조회·저장·갱신 세 동작의 이름이 거기서 왔다.
- AV-SkiM 편. SDR과 SI-SNR과 개선치의 i를 정리해 둔 자리. 이 편의 SI-SDRi와 NSR과 SI-SDRiC이 그 정의를 그대로 받는다.
- TDSE 편. 저자 구현이 없어 명세로 역산한 편. 이 편은 구현이 있어 방식이 갈린다.
논문이 인용한 것 가운데 이 글이 직접 연 것
- B. Zeng and M. Li, "USEF-TSE: Universal Speaker Embedding Free Target Speaker Extraction", IEEE TASLP, vol. 33, pp. 2110-2124, 2025. 이 논문의 백본이고, 화자 임베딩을 쓰지 않고 등록 파형을 그대로 받는 구조라 세그먼트를 이어 붙이는 것이 뜻이 있다.
- P. Lewis et al., "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks", NeurIPS 2020. 이 논문이 자기 얼개를 부르는 이름의 출처다.
- B. Desplanques, J. Thienpondt, K. Demuynck, "ECAPA-TDNN", Interspeech 2020. 신뢰도와 조회에 쓰는 화자 임베딩이다. 설정 파일이 가리키는 것은 WeSpeaker가 배포한 'wespeaker-ecapa-tdnn512-LM'이다.
- Z. Ma et al., "emotion2vec: Self-supervised Pre-training for Speech Emotion Representation", Findings of ACL 2024. 조회의 두 번째 스트림이다. 설정 파일에는 없고 모델 코드가 'iic/emotion2vec_plus_large'로 박아 둔다.
- Z. Zhang, B. He, Z. Zhang, "X-TaSNet: Robust and Accurate Time-Domain Speaker Extraction Network", Interspeech 2020, pp. 1421-1425. NSR의 정의가 여기서 왔다.
- J. R. Hershey, Z. Chen, J. Le Roux, S. Watanabe, "Deep Clustering", ICASSP 2016. WSJ0-2mix의 출처다.
- K. Zhou, B. Sisman, R. Liu, H. Li, "Emotional Voice Conversion: Theory, Databases and ESD", Speech Communication, vol. 137, pp. 1-18, 2022. 감정 축을 들여오는 데이터셋이다.
- J. Cosentino, M. Pariente, S. Cornell, A. Deleforge, E. Vincent, "LibriMix", 2020. 표 1의 셋째 평가 집합이다.
코드와 데이터
- 저자 공개 구현은 'github.com/IiuZiKai/Evo_TSE'이고 폴더에는 'Evo_TSE-main'으로 받아 두었다. 라이선스 파일이 없으므로 모든 권리가 유보돼 있다. 읽기 전용으로 두고 한 글자도 고치지 않았으며 코드를 옮겨 쓰지도 않았다.
- 없는 의존성 하나('python_speech_features')는 저자 파일을 고치지 않고 import만 비켜 갔다. 그 모듈은 파라미터를 갖지 않으므로 세는 값이 달라지지 않는다.
- 초록은 'Our code and checkpoints are available'이라 적지만 저장소에 가중치 파일이 없다. 확장자 여덟 가지를 전수로 찾아 0건이었고 README에도 배포처가 없다.
- 학습·평가 데이터(WSJ0-2mix·ESD·Libri2Mix 혼합)는 없다. 그래서 표 1·2·3·4의 dB와 NSR과 SI-SDRiC은 전부 재현 불가다. 저장소가 든 것은 파일 이름 목록뿐이고 그 경로는 저자 기계의 절대 경로다.
검산
- 7장의 모든 수치는 아래 환경에서 직접 실행한 결과이며, 입력값은 전부 논문 본문과 표 1~4와 그림 4·5의 캡션, 그리고 저자 설정 파일 넷과 소스에서 읽은 것이다.
- 'conda create -y -n paper-verify python=3.12 matplotlib numpy' · 'implementation/code/run_all.sh'
- 저자 구현이 있으나 배포 체크포인트가 없어 층을 옮겨 세어 총계와 맞추는 방식은 못 썼다. 대신 백본을 설정 파일 값 그대로 세워 파라미터를 세고, 인코더와 디코더는 층 정의에서 다시 유도해 센 값과 대조했다.
- 상수는 소스에서 읽는다. 커널 크기와 입력 채널과 클립 비율을 하드코딩하지 않았는데, 하드코딩하면 그 값을 거는 단언이 항등식이 되어 원리적으로 못 터지기 때문이다.
- 치환 자리를 문자열로 잡을 때는 쓰기 전에 유일성을 단언했다. 같은 키가 여러 블록에 있는 설정 파일에서는 값이 전부 같은지를 함께 단언한다.
- 판본 대조와 실행은 2026년 9월 1일에 했다.
- 이 글의 그림과 표 번호는 등장 순서를 따랐고, 논문 원본과 직접 만든 것은 각 캡션의 출처 줄이 가른다.
'ML+DL > Paper Note' 카테고리의 다른 글
- Total
- Today
- Yesterday
- 알고리즘
- 리스트
- 여행
- a6000
- RX100M5
- 백준
- 세모
- 면접 준비
- 스트림
- 지지
- 기술면접
- 야경
- 남미
- BOJ
- 세계여행
- 맛집
- 스프링
- Algorithm
- spring
- 유럽
- 유럽여행
- java
- 중남미
- 칼이사
- 파이썬
- 동적계획법
- 딥러닝
- 세계일주
- 자바
- Python
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |